AI Data Operations

AI Data Operations pour une IA multilingue fiable en production

Pangeanic conçoit et pilote la couche opérationnelle qui relie données multilingues et multimodales, retours humains, évaluation, confidentialité et gouvernance. Des jeux de données d'entraînement à la revue en production, chaque signal revient dans le système comme élément de preuve pour la décision suivante.

  • Données d'entraînement
  • Retours humains
  • Évaluation des modèles
  • Confidentialité
  • Amélioration continue

Pour les laboratoires d'IA, les entreprises et les institutions publiques qui opèrent dans plusieurs langues, domaines de spécialité et environnements réglementés.

Modèle opérationnel continu

AI Data Operations boucle le cycle complet de la preuve

AI Data Operations (opérations de données pour l'IA) est le système continu d'approvisionnement, d'acquisition de licences, de préparation, d'annotation, d'évaluation, de gouvernance et d'amélioration des données et des retours humains utilisés tout au long du cycle de vie de l'IA. Il transforme des tâches de données isolées en un modèle opérationnel capable d'apprendre de la production sans perdre la traçabilité ni le contrôle humain.

Les modèles, les jeux de données et les politiques évoluent sans cesse. Un système en production a besoin de plus qu'un projet d'annotation achevé ou qu'un benchmark mesuré un après-midi choisi par commodité. Il lui faut une boucle maîtrisée qui enregistre ce qui a changé, mesure l'effet de ce changement et réinjecte les nouveaux éléments de preuve dans la préparation des données, l'alignement et l'évaluation.

Pangeanic réunit cette boucle pour toutes les langues et toutes les modalités. L'expertise linguistique native, les réviseurs spécialisés par domaine, l'ingénierie en apprentissage automatique, les contrôles de confidentialité et l'évaluation versionnée fonctionnent au sein d'un flux de travail unique et auditable.

La boucle de la preuve

  1. Définir la tâche, le risque et les données manquantes
  2. Trouver les données nécessaires, les acquérir sous licence ou les collecter
  3. Les préparer, les annoter et les enrichir
  4. Recueillir les jugements humains et les signaux de politique
  5. Évaluer les performances au regard de la tâche réelle
  6. Versionner les éléments de preuve et améliorer le système
DE L'ACTIF DE DONNÉES À LA CAPACITÉ OPÉRATIONNELLE

Données pour l'IA, jeux de données pour l'IA et AI Data Operations répondent à des volets différents d'un même problème

Une équipe d'IA peut avoir besoin aujourd'hui d'un jeu de données précis et demain d'une opération de données continue. La distinction devient décisive dès que les modèles passent de l'expérimentation à la production et que s'accumulent de nouvelles erreurs, langues, domaines, politiques et exigences d'évaluation.

Pangeanic distingue ces couches de façon délibérée. Les données pour l'IA recouvrent les services nécessaires pour trouver, acquérir sous licence, collecter, préparer et valider des données d'entraînement et d'évaluation. Les jeux de données pour l'IA sont les actifs de données qui en résultent. AI Data Operations (opérations de données pour l'IA) est la couche continue qui versionne ces actifs, recueille de nouveaux éléments de preuve, évalue le comportement du modèle et transforme les enseignements de la production en prochaine décision sur les données.

01 · DONNÉES POUR L'IA

Des services qui produisent des données pour entraîner et évaluer l'IA

Recherche, acquisition de licences, collecte, préparation, annotation, enrichissement et anonymisation de données, retours humains et validation pour l'entraînement, l'adaptation, l'ancrage (grounding) et l'évaluation des modèles.

C'est la voie adaptée lorsque le besoin principal consiste à obtenir ou à constituer les données qu'exige une tâche d'IA précise.

02 · JEUX DE DONNÉES POUR L'IA

Des actifs de données prêts pour vos modèles

Jeux de données multilingues et multimodaux, disponibles sous licence ou créés sur mesure, pour la parole, le texte, la vision par ordinateur, l'intelligence documentaire, l'évaluation et l'IA spécialisée par domaine.

Un jeu de données livré dans les règles peut être concédé sous licence, versionné, audité, évalué et réutilisé selon les droits et le modèle de gouvernance convenus. Le client repart avec un actif, et non avec un exercice d'annotation ponctuel.

03 · AI DATA OPERATIONS

La couche opérationnelle continue

AI Data Operations relie données gouvernées, retours humains, évaluation, alignement, confidentialité et contrôle qualité tout au long du cycle de vie d'un système d'IA en production.

C'est le modèle adapté lorsque les besoins en données continuent d'évoluer après le déploiement et que les nouveaux éléments de preuve doivent être recueillis, tracés, évalués et convertis en prochain cycle d'amélioration.

QUELLE VOIE CORRESPOND À VOTRE BESOIN ?

Tout part de l'unité de valeur dont vous avez réellement besoin

« Nous avons besoin de données. »

Trouver, collecter, acquérir sous licence, annoter ou préparer le matériau nécessaire à l'entraînement, au fine-tuning, à l'ancrage ou à l'évaluation.

« Nous avons besoin d'un jeu de données. »

Acquérir ou commander un actif de données défini, avec un périmètre, une provenance, une licence, des métadonnées, des critères de qualité et un format de livraison convenus.

« Notre système ne cesse de générer de nouveaux problèmes de données. »

Mettre en place une boucle AI Data Operations permanente pour l'évaluation, les retours humains, la gouvernance, l'analyse des erreurs et l'amélioration continue des données.

Les modèles changent. L'infrastructure change. L'actif de données doit rester inspectable, portable et réutilisable selon les droits convenus avec le client. AI Data Operations préserve cette continuité pendant que le reste de la pile d'IA évolue.

Si le besoin couvre déjà l'acquisition de données, l'évaluation des modèles, les retours humains et l'amélioration en production, mieux vaut définir le modèle opérationnel avant de commander une nouvelle tâche de données isolée.

Parler de votre projet de données pour l'IA

Architecture opérationnelle

Une boucle de production, des fondations de données au déploiement gouverné

Un programme AI Data Operations peut démarrer par un jeu de données manquant, un besoin d'annotation, un écart de performance multilingue, un benchmark non atteint ou une contrainte de confidentialité. L'architecture relie ces points d'entrée afin que les données, le jugement humain et les éléments de preuve issus de la production restent intégrés au même système maîtrisé.

Architecture AI Data Operations de Pangeanic : fondations de données, retours humains, évaluation, gouvernance et amélioration en production
Les couches fonctionnent comme un système de rétroaction. De nouveaux éléments de preuve peuvent mettre à jour le jeu de données, le protocole d'évaluation, le comportement du modèle ou les règles de gouvernance.

Trois couches interconnectées

01 · Socle de preuves

Fondations de données

Identification de jeux de données, acquisition de licences, collecte, normalisation, métadonnées, provenance et spécifications de livraison pour la tâche que le système doit accomplir.

02 · Signaux humains

Comportement et alignement

Annotation, jugements d'experts, données d'instructions, paires de préférences, étiquettes de sécurité et révision multilingue qui façonnent le comportement du modèle.

03 · Couche de contrôle

Évaluation et gouvernance

Gold sets (jeux de référence), tests de régression, red teaming, contrôles de confidentialité, versionnage et retours de production qui apportent des preuves mesurables pour valider chaque version.

Capacités opérationnelles

Ce que Pangeanic prend en charge tout au long du cycle de vie de l'IA

Chaque capacité peut répondre à un besoin précis ou s'intégrer à un programme continu. Le modèle opérationnel maintient reliés les spécifications, les réviseurs, les preuves de qualité et les décisions de gouvernance à mesure que le système évolue.

Fondations de données

Recherche et collecte de jeux de données

Identifier, acquérir sous licence ou collecter des données textuelles, vocales, audio, image, vidéo, documentaires et d'évaluation, en fonction des langues, domaines, populations et conditions d'exploitation requis.

Découvrir les données pour l'IA →
Opérations humaines

Préparation, annotation et enrichissement des données

Normaliser, dédupliquer, segmenter, classer et enrichir les données avec des métadonnées linguistiques, sémantiques, géographiques, démographiques et métier, selon des protocoles d'assurance qualité définis.

Découvrir PECAT, la plateforme d'annotation →
Comportement

SFT, retours humains et alignement des modèles

Créer des données d'instructions, des démonstrations, des paires de préférences, des étiquettes de politique et des jugements d'experts dans différentes langues, cultures et domaines spécialisés.

Découvrir l'alignement des modèles et le RLHF →
Mesure

Évaluation des modèles, des agents et de la sécurité

Concevoir des gold sets, des grilles de notation, des évaluations humaines, des tests adversariaux et des suites de régression qui révèlent les schémas de défaillance avant et après chaque mise en production.

Découvrir l'évaluation et l'assurance qualité de l'IA →
Connaissances

RAG et ancrage des connaissances

Préparer des connaissances fiables grâce à la normalisation des documents, à la structuration sémantique, aux métadonnées et à l'évaluation de la recherche, puis vérifier que les réponses générées restent ancrées dans ces sources.

Découvrir les systèmes d'IA souveraine →
Contrôle

Confidentialité, gouvernance et livraison maîtrisée

Appliquer l'anonymisation multilingue, la minimisation des données, la traçabilité de la provenance, la gestion du consentement, le contrôle de versions et une livraison auditable dans les environnements réglementés ou sensibles.

Découvrir l'anonymisation et le masquage des données →

Cas d'usage représentatifs

Là où AI Data Operations change le résultat

Les organisations font généralement appel à Pangeanic lorsque l'objectif d'un modèle révèle un manque de données, ou lorsque les éléments de preuve issus de la production mettent au jour une faiblesse que l'entraînement générique n'a pas corrigée. Le travail peut commencer avant l'entraînement ou après le déploiement, mais il revient toujours à la même boucle maîtrisée.

Ingénieure en IA analysant le comportement d'un modèle lors d'un processus de personnalisation des données Construire et adapter

Modèles spécialisés et multilingues

Créer les fondations de données d'une nouvelle capacité ou adapter un modèle existant à une langue, un domaine, une politique ou un environnement d'exploitation précis.

Adaptation aux domaines spécialisés

Préparer des corpus spécialisés, des données d'instructions, de la terminologie, des annotations et des jeux d'évaluation pour des applications en finance, santé, secteur public, droit, industrie ou recherche scientifique.

Déploiement international des modèles

Tester et améliorer les performances dans différentes langues, dialectes, variantes régionales et contextes culturels, avec des données natives et une évaluation propre à chaque langue.

Découvrir les données d'entraînement multilingues pour l'IA →
Équipe d'opérations IA supervisant des agents, des systèmes RAG et les réponses des modèles Déployer et améliorer

Copilotes, systèmes RAG et agents d'IA

Relier des connaissances fiables, des protocoles d'évaluation et une révision humaine pour que les systèmes déployés puissent être mesurés au regard des tâches qu'ils doivent accomplir.

Ancrage dans les sources de connaissances

Normaliser les documents, définir les métadonnées et la logique de recherche, créer des tests de qualité des réponses et vérifier que celles-ci restent étayées par des sources approuvées.

Évaluation continue

Utiliser des gold sets, une notation par des experts, des tests adversariaux et des suites de régression pour détecter les changements de comportement à chaque mise à jour du modèle, des prompts, de la base de connaissances ou des politiques.

Découvrir l'évaluation et l'assurance qualité de l'IA →

Preuves opérationnelles documentées

Un modèle opérationnel fondé sur des projets déjà livrés

La terminologie est récente. Le travail qui la sous-tend ne l'est pas : acquisition de données multilingues, ingénierie de corpus, révision experte, évaluation, contrôles de confidentialité et livraison dans des environnements de recherche, d'infrastructures publiques et d'entreprise.

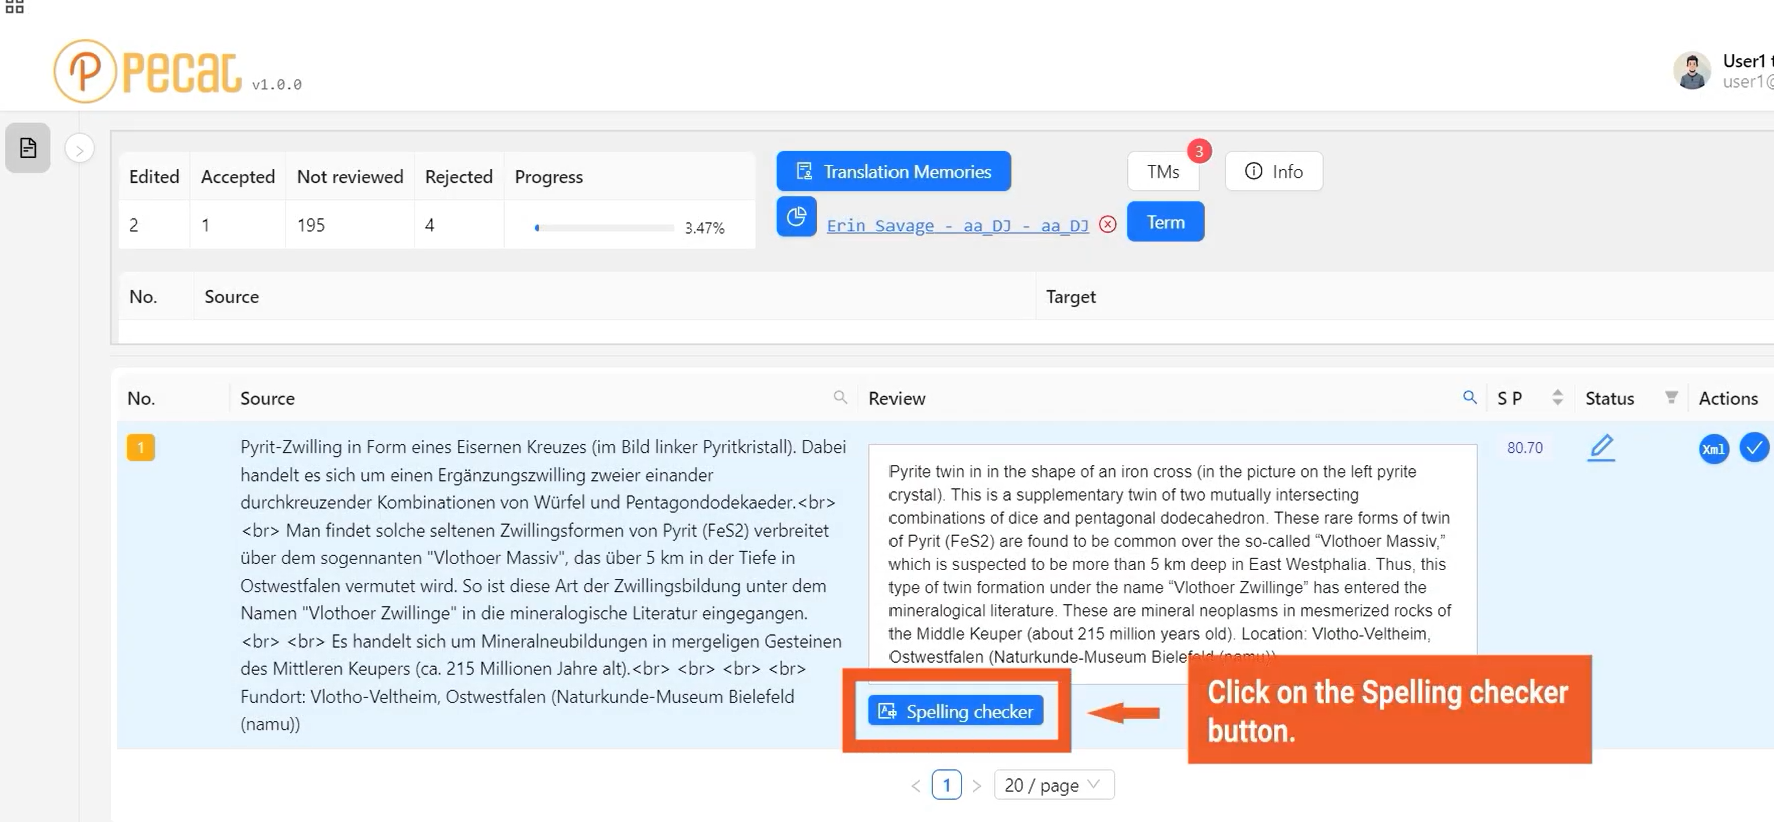
Interface de PECAT pour la post-édition multilingue et le contrôle qualité avec estimation de la qualité de la traduction automatique
Du flux de travail à la preuve

Le jugement humain n'a de valeur que si son contexte est conservé

Une note ou une étiquette a une valeur limitée sans la définition de la tâche, les consignes du réviseur, l'élément source, la version du modèle et les contrôles qualité qui l'ont produite. PECAT fournit l'environnement opérationnel qui capture ces relations et livre des données de révision inspectables et réutilisables.

La même rigueur s'applique aux corpus d'entraînement, aux données de préférence, aux gold sets et aux retours de production : la spécification, la provenance, le versionnage et l'export font partie du livrable.

Voir comment PECAT soutient le flux de travail →

Portabilité des actifs de données

Votre modèle changera. Votre actif de données ne devrait pas avoir à changer.

Un projet complet laisse à l'organisation un jeu de données ou un dossier de preuves qu'elle peut conserver, versionner, auditer et réutiliser dans le cadre des droits convenus pour chaque composant. Dans AI Data Operations, la portabilité est un attribut de la livraison, au même titre que la provenance, la gouvernance et le contrôle qualité.

Position contractuelle Ce qu'elle confère Ce que l'acheteur doit vérifier
Propriété Le client est propriétaire de l'actif et des droits qui en découlent. Quels matériaux sources, annotations et composants dérivés sont transférés.
Licence perpétuelle L'utilisation se poursuit sans limite de durée dans un périmètre défini, sans transfert de propriété. Modèles, applications, sociétés affiliées, territoires et usages dérivés autorisés.
Licence limitée L'utilisation est limitée dans le temps, par territoire, finalité, volume ou modèle. Conditions de renouvellement, restrictions, obligations de conservation et de réversibilité.
Accès Le matériel peut être utilisé tant que la relation contractuelle est en vigueur. Droits d'export, continuité, restitution des données et ce qui reste disponible après la fin du contrat.
Livraison complète

Ce que peut contenir le livrable

  • Données sources ou collectées
  • Données normalisées et segmentées
  • Annotations et jugements humains
  • Métadonnées linguistiques, métier et sémantiques
  • Provenance des sources
  • Registres de licences et de consentements
  • Versions du jeu de données et journal des modifications
  • Rapports de qualité et de couverture
  • Notes sur la représentativité
  • Jeux d'évaluation associés
  • Schémas et documentation
  • Formats d'export et de livraison

Le document de périmètre du projet précise quels composants s'appliquent. Toute exclusion doit être explicite avant le lancement de la production.

Rigueur contractuelle

Les droits déterminent ce qui peut être affirmé

Un matériel tiers fourni sous licence non exclusive reste un matériel sous licence. Pangeanic ne le présente pas comme une propriété transférable.

La collecte sur mesure, les contenus fournis par le client, les annotations dérivées et les actifs d'évaluation peuvent relever de droits différents. Nous documentons la position applicable composant par composant.

La portabilité signifie donc une livraison inspectable assortie de droits déclarés, et non la promesse générale que chaque source devient la propriété de l'acheteur.

Questions fréquentes

AI Data Operations : des réponses directes pour les acheteurs

Ces questions définissent la catégorie opérationnelle, les points d'entrée habituels et les droits à régler avant le démarrage d'un projet.

Qu'est-ce qu'AI Data Operations ?

AI Data Operations (opérations de données pour l'IA) est le système continu d'approvisionnement, d'acquisition de licences, de préparation, d'annotation, d'évaluation, de gouvernance et d'amélioration des données et des retours humains utilisés tout au long du cycle de vie de l'IA.

En quoi AI Data Operations diffère-t-il de l'annotation de données ?

L'annotation de données est l'un des flux de travail du système. AI Data Operations couvre également l'identification des données, les droits, la collecte, la préparation, les retours humains, les jeux d'évaluation, les contrôles de confidentialité, la provenance, le versionnage et les retours de production.

Faut-il disposer d'un jeu de données avant de commencer ?

Non. Un programme peut démarrer à partir d'un corpus existant ou d'un objectif de modèle et d'un manque de données documenté. Pangeanic peut identifier, acquérir sous licence ou collecter le matériel manquant avant de le préparer pour l'entraînement ou l'évaluation.

Le client est-il propriétaire du jeu de données final ?

Cela dépend des droits attachés à chaque composant. La position applicable peut être la propriété, une licence perpétuelle, une licence limitée ou un accès contractuel. Pangeanic documente cette position avant la contractualisation et ne présente pas un matériel tiers sous licence comme une propriété transférable.

Comment AI Data Operations soutient-il les systèmes d'IA multilingues ?

AI Data Operations traite la langue, la variante régionale, le dialecte, la terminologie et le contexte culturel comme des variables opérationnelles. Les spécifications de données, la révision native et les jeux d'évaluation peuvent ainsi être conçus séparément pour chaque marché et chaque condition d'exploitation du système.

Comment maintenir la qualité d'un système d'IA après son déploiement ?

Les gold sets, les suites de régression, la révision experte et une sélection de retours de production apportent des éléments de preuve à chaque changement de modèle, de prompts, de recherche ou de politiques. Les constats peuvent mettre à jour le jeu de données, le protocole d'évaluation, le comportement du modèle ou les règles de gouvernance.

Parlons-en

Construisez les opérations de données dont votre système d'IA a réellement besoin

Dites-nous ce que le modèle doit apprendre, où il va opérer et comment ses performances seront jugées. Nous vous aiderons à définir les données, la révision humaine, l'évaluation et la gouvernance nécessaires.