AI Data Operations

AI Data Operations para una IA multilingüe fiable en producción

Pangeanic diseña y gestiona la capa operativa que conecta datos multilingües y multimodales, feedback humano, evaluación, privacidad y gobernanza. Desde los datos de entrenamiento hasta la revisión en producción, cada señal vuelve al sistema como evidencia para la siguiente decisión.

  • Datos de entrenamiento
  • Feedback humano
  • Evaluación de modelos
  • Privacidad
  • Mejora continua

Para laboratorios de IA, empresas e instituciones públicas que trabajan con múltiples idiomas, dominios de especialidad y entornos regulados.

Modelo operativo continuo

AI Data Operations cierra el ciclo completo de la evidencia

AI Data Operations es el sistema continuo de obtención, licenciamiento, preparación, anotación, evaluación, gobernanza y mejora de los datos y del feedback humano que se utilizan a lo largo de todo el ciclo de vida de la IA. Convierte tareas de datos aisladas en un modelo operativo capaz de aprender de la producción sin perder trazabilidad ni control humano.

Los modelos, los conjuntos de datos y las políticas cambian constantemente. Un sistema en producción necesita algo más que un proyecto de anotación terminado o un benchmark medido una tarde elegida a conveniencia. Necesita un ciclo controlado que registre qué ha cambiado, mida su efecto y devuelva la nueva evidencia a la preparación de datos, el alineamiento y la evaluación.

Pangeanic integra ese ciclo en todos los idiomas y modalidades. La experiencia lingüística nativa, los revisores especializados en cada dominio, la ingeniería de aprendizaje automático, los controles de privacidad y la evaluación versionada funcionan dentro de un único flujo de trabajo auditable.

El ciclo de la evidencia

  1. Definir la tarea, el riesgo y la carencia de datos
  2. Obtener los datos necesarios, adquirirlos bajo licencia o recopilarlos
  3. Prepararlos, anotarlos y enriquecerlos
  4. Recoger los juicios humanos y las señales de políticas
  5. Evaluar el rendimiento frente a la tarea real
  6. Versionar la evidencia y mejorar el sistema
DEL ACTIVO DE DATOS A LA CAPACIDAD OPERATIVA

Datos para IA, datasets para IA y AI Data Operations resuelven partes distintas del mismo problema

Un equipo de IA puede necesitar hoy un dataset concreto y mañana una operación de datos continua. La diferencia cobra importancia cuando los modelos pasan de la experimentación a la producción y empiezan a acumularse nuevos errores, idiomas, dominios, políticas y requisitos de evaluación.

Pangeanic separa estas capas de forma deliberada. Datos para IA abarca los servicios necesarios para obtener, adquirir bajo licencia, recopilar, preparar y validar datos de entrenamiento y evaluación. Datasets para IA son los activos de datos resultantes. AI Data Operations (operaciones de datos para IA) es la capa continua que versiona esos activos, captura nueva evidencia, evalúa el comportamiento del modelo y convierte lo aprendido en producción en la siguiente decisión sobre los datos.

01 · DATOS PARA IA

Servicios que generan datos para entrenar y evaluar IA

Obtención, licenciamiento, recopilación, preparación, anotación, enriquecimiento y anonimización de datos, feedback humano y validación para el entrenamiento, la adaptación, el grounding y la evaluación de modelos.

Es la vía adecuada cuando la necesidad principal es obtener o construir los datos que requiere una tarea de IA concreta.

02 · DATASETS PARA IA

Activos de datos listos para los modelos

Datasets multilingües y multimodales, disponibles bajo licencia o creados a medida, para voz, texto, visión artificial, inteligencia documental, evaluación e IA especializada por dominio.

Un dataset bien entregado puede cederse bajo licencia, versionarse, auditarse, evaluarse y reutilizarse según los derechos y el modelo de gobernanza acordados. El cliente se queda con un activo, no con un ejercicio de anotación puntual.

03 · AI DATA OPERATIONS

La capa operativa continua

AI Data Operations conecta datos gobernados, feedback humano, evaluación, alineamiento, privacidad y control de calidad durante todo el ciclo de vida de un sistema de IA en producción.

Es el modelo adecuado cuando los requisitos de datos siguen cambiando después del despliegue y la nueva evidencia debe capturarse, trazarse, evaluarse y convertirse en el siguiente ciclo de mejora.

¿QUÉ VÍA ENCAJA CON LA NECESIDAD?

Todo empieza por la unidad de valor que realmente se necesita

«Necesitamos datos».

Obtener, recopilar, adquirir bajo licencia, anotar o preparar el material necesario para entrenamiento, fine-tuning, grounding o evaluación.

«Necesitamos un dataset».

Adquirir o encargar un activo de datos definido, con alcance, procedencia, licencia, metadatos, criterios de calidad y formato de entrega acordados.

«Nuestro sistema no deja de generar nuevos problemas de datos».

Establecer un ciclo permanente de AI Data Operations para la evaluación, el feedback humano, la gobernanza, el análisis de errores y la mejora continua de los datos.

Los modelos cambian. La infraestructura cambia. El activo de datos debe seguir siendo inspeccionable, portable y reutilizable según los derechos acordados con el cliente. AI Data Operations preserva esa continuidad mientras evoluciona el resto del stack de IA.

Si la necesidad ya abarca la adquisición de datos, la evaluación de modelos, el feedback humano y la mejora en producción, conviene definir el modelo operativo antes de encargar otra tarea de datos aislada.

Consultar un proyecto de datos para IA

Arquitectura operativa

Un ciclo de producción desde los cimientos de datos hasta el despliegue gobernado

Un programa de AI Data Operations puede empezar por un dataset que falta, una necesidad de anotación, una brecha de rendimiento multilingüe, un benchmark que no se supera o una restricción de privacidad. La arquitectura conecta esos puntos de entrada para que los datos, el criterio humano y la evidencia de producción formen parte del mismo sistema controlado.

Arquitectura de AI Data Operations de Pangeanic: cimientos de datos, feedback humano, evaluación, gobernanza y mejora en producción
Las capas funcionan como un sistema de retroalimentación. La nueva evidencia puede actualizar el dataset, el protocolo de evaluación, el comportamiento del modelo o las reglas de gobernanza.

Tres capas conectadas

01 · Base de evidencia

Cimientos de datos

Identificación de datasets, licenciamiento, recopilación, normalización, metadatos, procedencia y especificaciones de entrega para la tarea que debe realizar el sistema.

02 · Señales humanas

Comportamiento y alineamiento

Anotación, juicios de expertos, datos de instrucciones, pares de preferencias, etiquetas de seguridad y revisión multilingüe que moldean el comportamiento del modelo.

03 · Capa de control

Evaluación y gobernanza

Gold sets (conjuntos de referencia), pruebas de regresión, red teaming, controles de privacidad, versionado y feedback de producción que aportan evidencia medible para aprobar cada versión.

Capacidades operativas

Qué gestiona Pangeanic a lo largo del ciclo de vida de la IA

Cada capacidad puede resolver una necesidad concreta o integrarse en un programa continuo. El modelo operativo mantiene conectadas las especificaciones, los revisores, la evidencia de calidad y las decisiones de gobernanza a medida que el sistema evoluciona.

Cimientos de datos

Obtención y recopilación de datasets

Identificar, adquirir bajo licencia o recopilar datos de texto, voz, audio, imagen, vídeo, documentos y evaluación según los idiomas, dominios, poblaciones y condiciones de funcionamiento requeridos.

Descubrir Datos para IA →
Operaciones humanas

Preparación, anotación y enriquecimiento de datos

Normalizar, deduplicar, segmentar, clasificar y enriquecer datos con metadatos lingüísticos, semánticos, geográficos, demográficos y de dominio, conforme a protocolos de control de calidad definidos.

Descubrir PECAT, la plataforma de anotación →
Comportamiento

SFT, feedback humano y alineamiento de modelos

Crear datos de instrucciones, demostraciones, pares de preferencias, etiquetas de políticas y juicios de expertos en distintos idiomas, culturas y dominios especializados.

Descubrir alineamiento de modelos y RLHF →
Medición

Evaluación de modelos, agentes y seguridad

Diseñar gold sets, rúbricas de puntuación, evaluaciones humanas, pruebas adversariales y baterías de regresión que revelen patrones de fallo antes y después de cada lanzamiento.

Descubrir evaluación y QA de IA →
Conocimiento

RAG y grounding del conocimiento

Preparar conocimiento fiable mediante normalización de documentos, estructura semántica, metadatos y evaluación de la recuperación, y verificar después que las respuestas generadas siguen fundamentadas en él.

Descubrir sistemas de IA soberana →
Control

Privacidad, gobernanza y entrega controlada

Aplicar anonimización multilingüe, minimización de datos, registros de procedencia, lógica de consentimiento, control de versiones y entrega auditable en entornos regulados o sensibles.

Descubrir anonimización y enmascaramiento de datos →

Casos de uso representativos

Dónde AI Data Operations cambia el resultado

Las organizaciones suelen incorporar a Pangeanic al ciclo de vida de la IA cuando el objetivo de un modelo pone de manifiesto una carencia de datos, o cuando la evidencia de producción revela una debilidad que el entrenamiento genérico no ha resuelto. El trabajo puede empezar antes del entrenamiento o después del despliegue, pero siempre vuelve al mismo ciclo controlado.

Ingeniera de IA revisando el comportamiento de un modelo durante un proceso de personalización de datos Construir y adaptar

Modelos especializados y multilingües

Crear los cimientos de datos para una nueva capacidad o adaptar un modelo existente a un idioma, dominio, política o entorno operativo concretos.

Adaptación a dominios especializados

Preparar corpus especializados, datos de instrucciones, terminología, anotaciones y conjuntos de evaluación para aplicaciones en finanzas, salud, administración pública, derecho, industria o ciencia.

Expansión global de modelos

Probar y mejorar el rendimiento en distintos idiomas, dialectos, variedades regionales y contextos culturales con datos nativos y evaluación específica para cada idioma.

Descubrir los datos de entrenamiento multilingües para IA →
Equipo de operaciones de IA supervisando agentes, sistemas RAG y respuestas de modelos Desplegar y mejorar

Copilotos, sistemas RAG y agentes de IA

Conectar conocimiento fiable, protocolos de evaluación y revisión humana para que los sistemas desplegados puedan medirse frente a las tareas que deben realizar.

Grounding en fuentes de conocimiento

Normalizar documentos, definir metadatos y lógica de recuperación, crear pruebas de calidad de las respuestas y verificar que estas siguen respaldadas por fuentes aprobadas.

Evaluación continua

Utilizar gold sets, puntuación experta, pruebas adversariales y baterías de regresión para detectar cambios de comportamiento tras cada actualización del modelo, los prompts, la base de conocimiento o las políticas.

Descubrir evaluación y QA de IA →

Evidencia operativa documentada

Un modelo operativo respaldado por proyectos ya entregados

La terminología es reciente. El trabajo que hay detrás no lo es: adquisición de datos multilingües, ingeniería de corpus, revisión experta, evaluación, controles de privacidad y entrega en entornos de investigación, infraestructuras públicas y empresas.

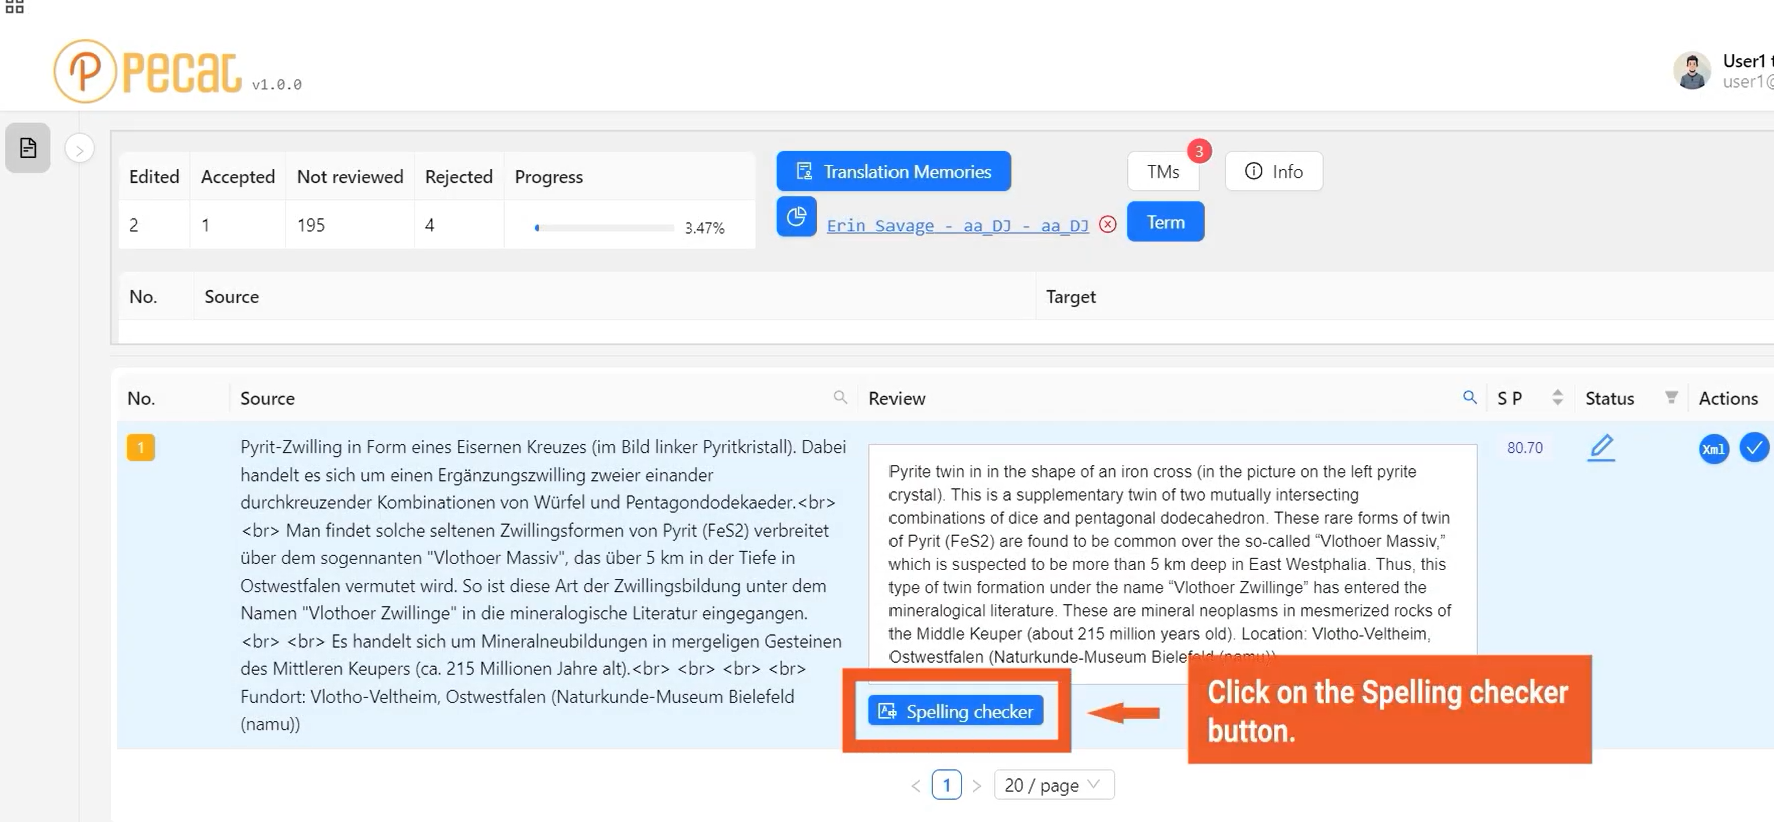
Interfaz de PECAT para posedición multilingüe y control de calidad con estimación de la calidad de la traducción automática
Del flujo de trabajo a la evidencia

El criterio humano es útil cuando se conserva su contexto

Una puntuación o una etiqueta tiene un valor limitado sin la definición de la tarea, las instrucciones del revisor, el elemento de origen, la versión del modelo y los controles de calidad que la produjeron. PECAT es el entorno operativo que captura esas relaciones y entrega datos de revisión que pueden inspeccionarse y reutilizarse.

La misma disciplina se aplica a los corpus de entrenamiento, los datos de preferencias, los gold sets y el feedback de producción: la especificación, la procedencia, el versionado y la exportación forman parte del entregable.

Ver cómo PECAT da soporte al flujo de trabajo →

Portabilidad de los activos de datos

Los modelos cambian. El activo de datos no tiene por qué cambiar con ellos.

Un proyecto completo deja a la organización un dataset o un paquete de evidencias que puede conservar, versionar, auditar y reutilizar dentro de los derechos acordados para cada componente. En AI Data Operations, la portabilidad es un atributo de la entrega, junto con la procedencia, la gobernanza y el control de calidad.

Posición contractual Qué otorga Qué debe verificar el comprador
Propiedad El cliente es titular del activo y de los derechos que se derivan de él. Qué materiales de origen, anotaciones y componentes derivados se transfieren.
Licencia perpetua El uso continúa de forma indefinida dentro de un ámbito definido, sin transferencia de la titularidad. Modelos, aplicaciones, empresas del grupo, territorios y usos derivados permitidos.
Licencia limitada El uso está restringido por plazo, territorio, finalidad, volumen o modelo. Condiciones de renovación, restricciones, requisitos de conservación y obligaciones a la finalización.
Acceso El material puede utilizarse mientras la relación contractual esté vigente. Derechos de exportación, continuidad, devolución de los datos y qué sigue disponible tras la finalización del contrato.
Entrega completa

Qué puede incluir el paquete de entrega

  • Datos de origen o recopilados
  • Datos normalizados y segmentados
  • Anotaciones y juicios humanos
  • Metadatos lingüísticos, de dominio y semánticos
  • Procedencia de las fuentes
  • Registros de licencias y consentimientos
  • Versiones del dataset y registro de cambios
  • Informes de calidad y cobertura
  • Notas sobre representatividad
  • Conjuntos de evaluación asociados
  • Esquemas y documentación
  • Formatos de exportación y entrega

El documento de alcance del proyecto especifica qué componentes se incluyen. Cualquier exclusión debe quedar explícita antes de iniciar la producción.

Precisión contractual

Los derechos determinan lo que puede afirmarse

El material de terceros suministrado bajo licencia no exclusiva sigue siendo material bajo licencia. Pangeanic no lo presenta como propiedad transferible.

La recopilación a medida, los contenidos aportados por el cliente, las anotaciones derivadas y los activos de evaluación pueden tener derechos distintos. Documentamos la posición aplicable componente a componente.

Por tanto, la portabilidad significa una entrega inspeccionable con derechos declarados, no una promesa genérica de que todas las fuentes pasan a ser propiedad del comprador.

Preguntas frecuentes

AI Data Operations: respuestas directas para compradores

Estas preguntas definen la categoría operativa, los puntos de entrada habituales y los derechos que conviene acordar antes de iniciar un proyecto.

¿Qué es AI Data Operations?

AI Data Operations (operaciones de datos para IA) es el sistema continuo de obtención, licenciamiento, preparación, anotación, evaluación, gobernanza y mejora de los datos y del feedback humano que se utilizan a lo largo de todo el ciclo de vida de la IA.

¿En qué se diferencia AI Data Operations de la anotación de datos?

La anotación de datos es uno de los flujos de trabajo del sistema. AI Data Operations abarca además la identificación de datos, los derechos, la recopilación, la preparación, el feedback humano, los conjuntos de evaluación, los controles de privacidad, la procedencia, el versionado y el feedback de producción.

¿Hace falta disponer de un dataset antes de empezar?

No. Un programa puede empezar con un corpus existente o con un objetivo de modelo y una carencia de datos documentada. Pangeanic puede identificar, adquirir bajo licencia o recopilar el material que falta antes de prepararlo para el entrenamiento o la evaluación.

¿El cliente es propietario del dataset final?

Depende de los derechos asociados a cada componente. La posición aplicable puede ser la propiedad, una licencia perpetua, una licencia limitada o un acceso contractual. Pangeanic documenta esa posición antes de la contratación y no presenta el material de terceros bajo licencia como propiedad transferible.

¿Cómo ayuda AI Data Operations a los sistemas de IA multilingües?

AI Data Operations trata el idioma, la variante regional, el dialecto, la terminología y el contexto cultural como variables operativas. Así, las especificaciones de datos, la revisión nativa y los conjuntos de evaluación pueden diseñarse por separado para cada mercado y cada condición en que funcionará el sistema.

¿Cómo se mantiene la calidad de un sistema de IA después del despliegue?

Los gold sets, las baterías de regresión, la revisión experta y una selección del feedback de producción aportan evidencia ante cada cambio de modelo, prompts, recuperación o políticas. Los hallazgos pueden actualizar el dataset, el protocolo de evaluación, el comportamiento del modelo o las reglas de gobernanza.

Hablemos

Operaciones de datos a la medida de lo que el sistema de IA realmente necesita

Basta con explicar qué debe aprender el modelo, dónde va a operar y cómo se va a juzgar su rendimiento. Pangeanic ayuda a definir los datos, la revisión humana, la evaluación y la gobernanza necesarios.