

Données d’entraînement prêtes à l’emploi (OTS)
L’infrastructure d’une IA prête pour la production
Les données d’entraînement prêtes à l’emploi constituent la voie la plus rapide vers des systèmes d’IA prêts pour la production. Alors que le secteur dépasse progressivement les interfaces conversationnelles génériques, les entreprises sont de moins en moins limitées par la disponibilité des modèles et de plus en plus par l’accès à des données fiables, spécialisées par domaine, sélectionnées et préparées pour être déployées et gouvernées.
L'infrastructure pour des systèmes d'IA prêts pour la production
Les données d'entraînement prêtes à l'emploi constituent la voie la plus rapide vers des systèmes d'IA opérationnels. Alors que le secteur évolue au-delà des interfaces conversationnelles génériques, les entreprises sont de moins en moins limitées par la disponibilité des modèles et de plus en plus par l'accès à des ressources de données fiables, spécialisées par domaine, sélectionnées et préparées pour être déployées et gouvernées.
Gartner prédit qu'en 2027, les organisations utiliseront des modèles d'IA spécifiques à une tâche trois fois plus que les LLM à usage général. Ce changement reflète une évolution structurelle : la performance, le coût et la fiabilité sont de plus en plus déterminés par la qualité des données, leur provenance, leur évaluation et leur alignement, plutôt que par le simple nombre de paramètres.
Les modèles sont devenus plus interchangeables. Les données, non. Pangeanic fournit des ensembles de données prêts à l'emploi conçus pour une intégration immédiate dans les workflows d'IA d'entreprise, prenant en charge les déploiements multilingues, réglementés et opérationnellement exigeants.
Vous êtes sur cette page car...
Les données sélectionnées transforment les modèles en systèmes
L'IA de production nécessite plus que des modèles de base. Elle exige des corpus multilingues, des ensembles d'instructions, des ressources audio, des annotations d'images et de vidéos, une préparation respectueuse de la vie privée, ainsi que des pipelines d'évaluation qui résistent aux conditions d'entreprise.
Contexte Pangeanic : plus de deux décennies dans le TALN multilingue, plus de 10 milliards de segments alignés, des workflows d'annotation et de validation, des déploiements à l'échelle nationale et une participation à des programmes européens tels que NTEU, MAPA, ELE, ainsi qu'à des initiatives d'espaces de données.
Qu'est-ce que les données d'entraînement prêtes à l'emploi ?
Les données d'entraînement prêtes à l'emploi désignent des ensembles de données précollectés, nettoyés et prêts pour les modèles, qui peuvent être utilisés directement pour le fine-tuning, l'ancrage via RAG, l'évaluation par rapport à des benchmarks vérifiés et l'apprentissage par instruction pour les workflows agentiques. Ces ressources réduisent le temps entre l'expérimentation et le déploiement car elles éliminent une grande partie des goulots d'étranglement liés à la collecte de données.
Contrairement aux corpus bruts à l'échelle du web, ces ensembles de données sont préparés pour une utilisation opérationnelle. Cela inclut généralement la déduplication, l'enrichissement des métadonnées, l'alignement multilingue lorsque nécessaire, la clarté des droits d'utilisation et le filtrage respectueux de la vie privée. Pour l'IA d'entreprise et du secteur public, ces couches sont particulièrement pertinentes car elles améliorent le contrôle et réduisent l'incertitude inutile dans les systèmes en aval.
Vitesse
Les ensembles de données sélectionnés et préparés éliminent des mois de collecte, de nettoyage et de cycles d'annotation manuels.
Fiabilité
Les ensembles de données structurés réduisent le risque d'hallucinations grâce à des entrées ancrées et contraintes par domaine.
Contrôle
Les entreprises maintiennent une visibilité plus claire sur les entrées d'entraînement, les conditions de licence et la logique d'évaluation.
Efficacité
Des modèles plus petits entraînés sur des données de haute fidélité donnent souvent de meilleurs résultats dans des workflows spécialisés.
Corpus haute densité par modalité
Pangeanic propose des données d'entraînement prêtes à l'emploi couvrant plusieurs modalités. L'objectif n'est pas le volume pour le volume, mais des ressources utilisables, disponibles sous licence et prêtes à être intégrées aux modèles et aux workflows d'entraînement, d'adaptation et d'évaluation de l'IA, avec moins de surprises opérationnelles.
Données textuelles et linguistiques multilingues
Corpus parallèles, corpus monolingues et ressources textuelles multilingues sous licence, préparés pour la traduction automatique, la recherche multilingue, l'adaptation de domaine et l'entraînement des LLM.
- Corpus parallèles dans des centaines de combinaisons linguistiques
- Corpus monolingues à grande échelle pour l'entraînement et l'adaptation des LLM
- Contenu sous licence provenant d'éditeurs, de services d'actualités, de diffuseurs et d'autres sources dont les droits d'utilisation sont établis
- Formats prêts à être intégrés aux modèles, tels que TMX, CSV et JSONL selon le cas d'usage
Données d'instruction et conversationnelles
Ensembles de données question-réponse, paires de prompts-réponses et corpus de dialogue préparés pour le fine-tuning supervisé, l'apprentissage par instruction, les workflows agentiques et les tâches d'alignement.
- Ensembles de données question-réponse pour l'instruction des modèles
- Corpus de dialogue pour les assistants et les flux d'interaction d'entreprise
- Prompts structurés pour le raisonnement multi-étapes et l'adaptation des workflows
- Sous-ensembles revus par des humains pour l'évaluation et l'alignement
Données audio et vocales
Ensembles de données vocales pour la reconnaissance automatique de la parole (ASR) et la synthèse vocale (TTS), incluant des corpus annotés, une couverture des accents et des langues, des enregistrements à deux canaux et des données vocales spécifiques à un domaine pour les systèmes d'IA opérationnels.
- Ensembles de données ASR et TTS dans plusieurs langues, accents et canaux
- Données téléphoniques à deux canaux et de style réunion
- Corpus enrichis de métadonnées pour la transcription et l'adaptation des modèles vocaux
- Préparation pour les environnements multilingues et sensibles
Ensembles de données d'images
Ensembles de données visuelles structurées allant des portraits aux images de nourriture, paysages, images commerciales et ressources orientées OCR pour la classification, la détection et les tâches vision-langage.
- Images annotées pour la classification et la détection
- Cas d'usage couvrant les portraits, la nourriture, les paysages et les images liées aux documents
- Métadonnées et étiquetage pour l'adaptation des modèles et le benchmarking
- Préparation pour les workflows de vision par ordinateur et multimodaux
Données vidéo et multimodales
Ensembles de données vidéo et corpus multimodaux avec annotation temporelle, étiquetage de scènes, reconnaissance d'actions et étiquetage d'événements pour les systèmes d'IA avancés.
- Annotation temporelle et segmentation au niveau des événements
- Étiquetage des scènes, des actions et des objets
- Préparation pour les systèmes de raisonnement et de récupération multimodaux
- Prise en charge des workflows combinant texte, image, vidéo et métadonnées
Couches d'annotation, de métadonnées et de droits d'utilisation
Ce qui distingue les données prêtes pour les modèles n'est souvent pas le volume de collecte brut, mais les couches opérationnelles qui l'entourent : provenance, métadonnées, droits, validation et adéquation à l'usage.
- Services d'annotation pour les données textuelles, vocales, d'images et vidéo
- Ingénierie de métadonnées pour le domaine, la langue, la source et le contexte
- Droits d'utilisation définis et provenance traçable lorsque la licence s'applique
- Sous-ensembles d'évaluation pour le benchmarking et la validation de production
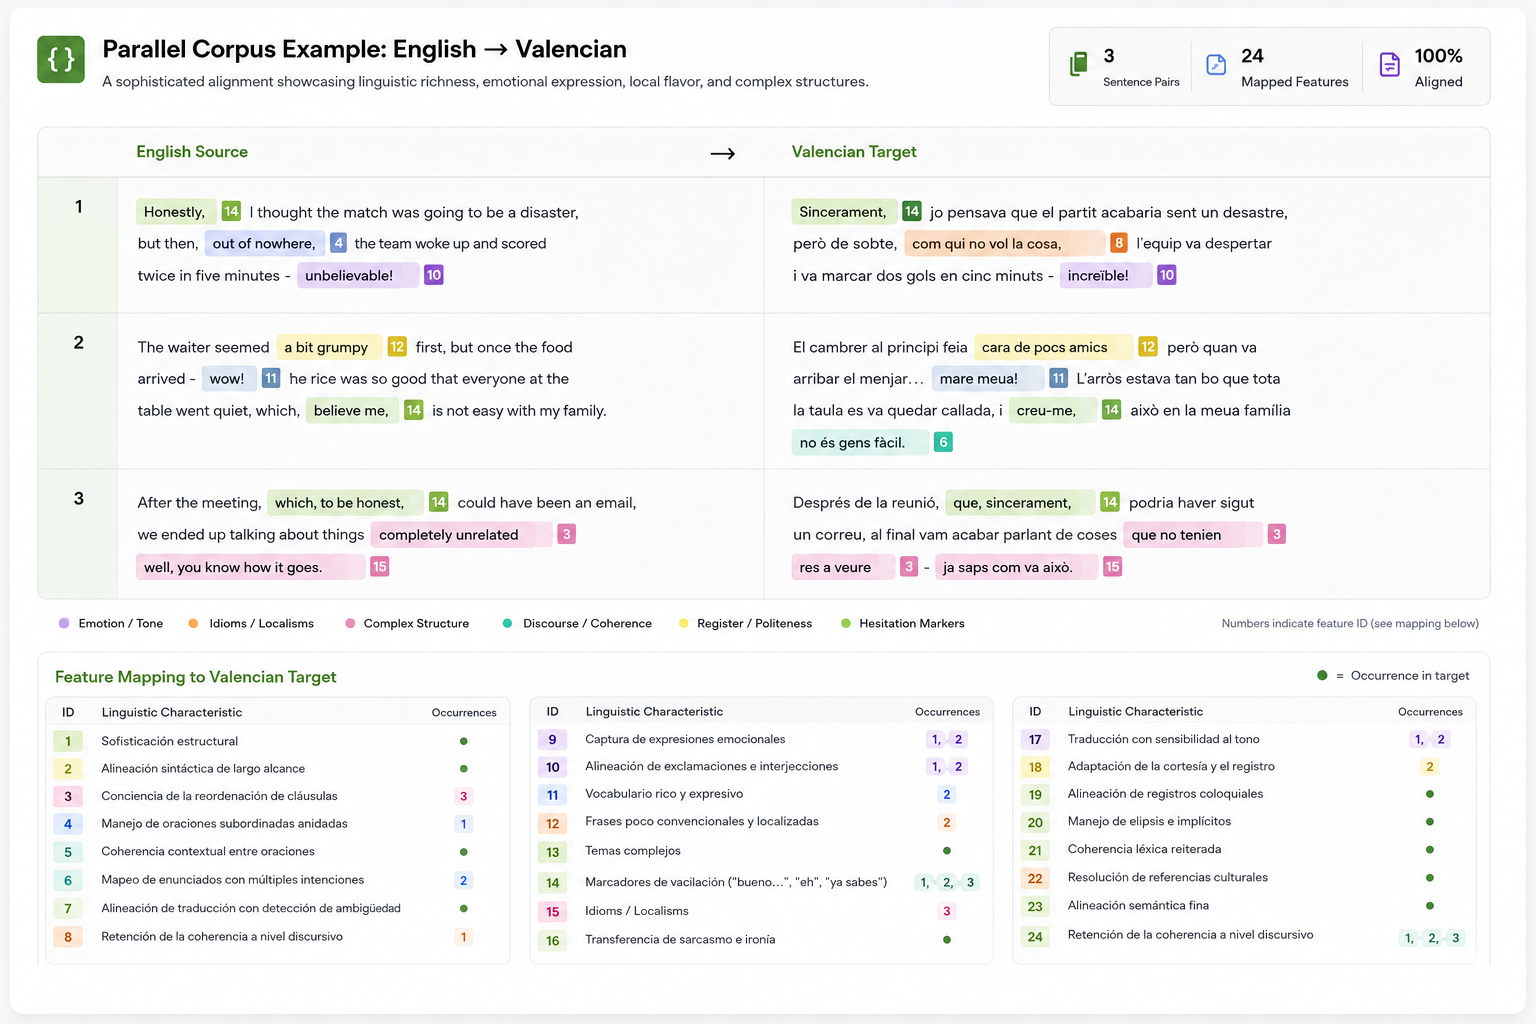
Explorer des catégories spécifiques d'ensembles de données
Les données d'entraînement prêtes à l'emploi couvrent plusieurs modalités. Chaque type d'ensemble de données introduit des contraintes, des exigences d'annotation et des modèles de déploiement différents.
Ensembles de données vocales
ASR, TTS, audio multilingue et corpus vocaux annotés pour les systèmes d'IA d'entreprise.
Ensembles de données d'images
Ensembles de données visuelles annotées pour la classification, la détection, l'OCR et l'IA multimodale.
Données LLM monolingues
Corpus à grande échelle pour l'adaptation de domaine, le pré-entraînement et les modèles linguistiques d'entreprise.
Jeux de données d'apprentissage par instruction
Ensembles de données question-réponse et d'alignement pour les SLM, les assistants et les workflows agentiques.
Données vidéo et multimodales
Annotation temporelle, détection de scènes et ensembles de données d'entraînement multimodaux.