Datos de entrenamiento listos para usar (OTS - Off-the-Shelf)
La infraestructura para una IA preparada para producción
Los datos de entrenamiento listos para usar representan la vía más rápida hacia una IA de calidad comercial. A medida que la industria deja atrás las interfaces de chat genéricas, las empresas se encuentran limitadas cada vez menos por la disponibilidad de modelos y cada vez más por el acceso a datos seleccionados y específicos de su sector en los que puedan confiar, desplegar y gobernar.
La infraestructura para una IA lista para producción
Los datos de entrenamiento listos para usar son el camino más rápido hacia una IA de grado productivo. A medida que la industria deja atrás las interfaces de chat genéricas, las empresas se ven limitadas cada vez menos por la disponibilidad de modelos y más por el acceso a datos específicos de dominio, curados y en los que puedan confiar, desplegar y gobernar.
Gartner predice que, para 2027, las organizaciones utilizarán modelos de IA específicos para tareas tres veces más que los LLM de propósito general. Este cambio refleja una transformación estructural: el rendimiento, el coste y la fiabilidad dependen cada vez más de la calidad de los datos, su procedencia, su evaluación y su alineación, y no solo del número de parámetros.
Los modelos se han vuelto más intercambiables. Los datos, no. Pangeanic proporciona conjuntos de datos listos para usar, diseñados para integrarse de inmediato en los flujos de trabajo de IA empresarial, compatibles con despliegues multilingües, regulados y operativamente exigentes.
HA LLEGADO A esta página porque...
Los datos curados son los que convierten los modelos en sistemas
La IA en producción requiere más que modelos base. Requiere corpus multilingües, conjuntos de datos de instrucciones, recursos de voz, anotación de imágenes y vídeo, preparación con conciencia de privacidad y canalizaciones de evaluación que resistan las condiciones empresariales.
Contexto de Pangeanic: más de dos décadas en PLN multilingüe, más de 10 000 millones de segmentos alineados, flujos de trabajo de anotación y validación, despliegues a escala nacional y participación en programas europeos como NTEU, MAPA, ELE e iniciativas de espacios de datos.
¿Qué son los datos de entrenamiento listos para usar?
Los datos de entrenamiento listos para usar se refieren a conjuntos de datos recopilados previamente, limpios y listos para modelos, que pueden utilizarse directamente para el ajuste fino (fine-tuning), la fundamentación mediante RAG, la evaluación frente a puntos de referencia verificados y el ajuste de instrucciones para flujos de trabajo de agentes. Estos activos reducen el tiempo entre la experimentación y el despliegue, ya que eliminan gran parte del cuello de botella en la recopilación de datos.
A diferencia de los corpus brutos a escala web, estos conjuntos de datos están preparados para su uso operativo. Esto generalmente incluye la desduplicación, el enriquecimiento de metadatos, la alineación multilingüe cuando sea necesario, la claridad de los derechos de uso y el filtrado con conciencia de privacidad. Para la IA empresarial y del sector público, estas capas son muy relevantes porque mejoran el control y reducen la incertidumbre innecesaria en los sistemas posteriores.
Velocidad
Los conjuntos de datos precurados eliminan meses de ciclos manuales de recopilación, limpieza y anotación.
Fiabilidad
Los conjuntos de datos estructurados reducen el riesgo de alucinaciones mediante entradas bien fundamentadas y restringidas al dominio.
Control
Las empresas mantienen una visibilidad más clara sobre las entradas de entrenamiento, las condiciones de licencia y la lógica de evaluación.
Eficiencia
Los modelos más pequeños entrenados con datos de alta fidelidad suelen rendir mejor en flujos de trabajo especializados.
Corpus de alta densidad por modalidad
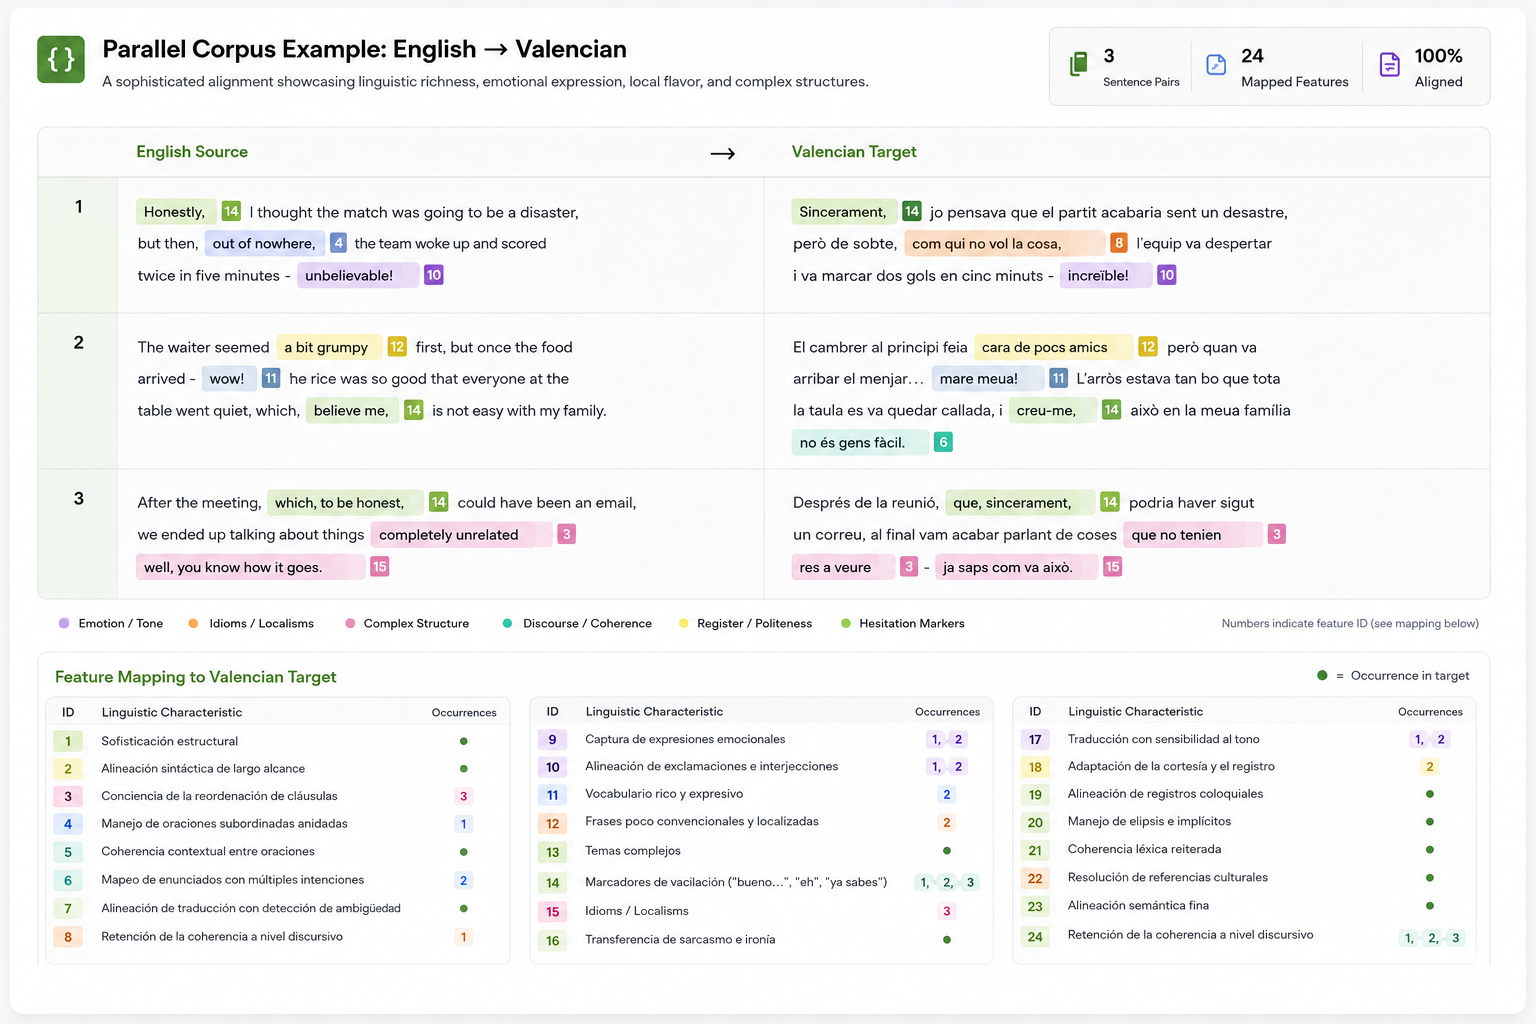
Pangeanic mantiene datos de entrenamiento listos para usar en múltiples modalidades. El objetivo no es el volumen por sí mismo, sino activos utilizables, con licencia y listos para modelos, que puedan integrarse en los flujos de trabajo de entrenamiento, adaptación y evaluación de IA con menos sorpresas operativas.
Datos de texto e idiomas multilingües
Corpus paralelos, corpus monolingües y activos de texto multilingüe con licencia, preparados para la traducción automática, la recuperación interlingüística, la adaptación de dominio y el entrenamiento de LLM.
- Corpus paralelos en cientos de combinaciones de idiomas
- Corpus monolingües a gran escala para el entrenamiento y la adaptación de LLM
- Contenido con licencia de editoriales, servicios de noticias, emisoras y otras fuentes con derechos aclarados
- Formatos listos para modelos, como TMX, CSV y JSONL, según el caso de uso
Datos de instrucciones y conversacionales
Conjuntos de datos de preguntas y respuestas, pares de indicación-respuesta (prompt-response) y corpus de diálogo preparados para el ajuste fino supervisado, el ajuste de instrucciones, los flujos de trabajo de agentes y las tareas de alineación.
- Conjuntos de datos de preguntas y respuestas para modelos de instrucciones
- Corpus de diálogo para asistentes y flujos de interacción empresarial
- Indicaciones (prompts) estructuradas para el razonamiento en varios pasos y la adaptación de flujos de trabajo
- Subconjuntos revisados por humanos para trabajos de evaluación y alineación
Datos de voz y audio
Conjuntos de datos de voz para ASR (reconocimiento automático de voz) y TTS (síntesis de voz), que incluyen voz anotada, cobertura de acentos e idiomas, audio de doble canal y datos de voz específicos de dominio para sistemas de IA operativos.
- Conjuntos de datos de ASR y TTS en varios idiomas, acentos y canales
- Datos de telefonía de doble canal y estilo de reuniones
- Corpus enriquecidos con metadatos para la transcripción y la adaptación de modelos de voz
- Preparación para entornos multilingües y de uso sensible
Conjuntos de datos de imágenes
Conjuntos de datos visuales estructurados que van desde retratos hasta comida, paisajes, imágenes minoristas y activos orientados a OCR para tareas de clasificación, detección y visión-lenguaje.
- Imágenes anotadas para clasificación y detección
- Casos de uso que abarcan retratos, comida, paisajes e imágenes relacionadas con documentos
- Metadatos y etiquetado para la adaptación de modelos y las pruebas de referencia
- Preparación para flujos de trabajo de visión por ordenador y entrenamiento multimodal
Datos de vídeo y multimodales
Conjuntos de datos de vídeo y corpus multimodales con anotación temporal, etiquetado de escenas, reconocimiento de acciones y etiquetado de eventos para sistemas de IA avanzados.
- Anotación temporal y segmentación a nivel de eventos
- Etiquetado de escenas, acciones y objetos
- Preparación para sistemas de razonamiento y recuperación multimodales
- Compatibilidad con flujos de trabajo que combinan texto, imagen, vídeo y metadatos
Capas de anotación, metadatos y licencias
Lo que distingue a los datos listos para modelos a menudo no es el volumen bruto de recopilación, sino las capas operativas en torno a ellos: procedencia, metadatos, derechos, validación y adecuación al uso.
- Servicios de anotación para datos de texto, voz, imagen y vídeo
- Ingeniería de metadatos para dominio, idioma, fuente y contexto
- Derechos de uso definidos y procedencia rastreable donde se apliquen licencias
- Subconjuntos de evaluación para pruebas de referencia y validación en producción
Explore categorías específicas de conjuntos de datos
Los datos de entrenamiento listos para usar abarcan múltiples modalidades. Cada tipo de conjunto de datos introduce restricciones, requisitos de anotación y patrones de despliegue distintos.
Conjuntos de datos de voz
ASR, TTS, audio multilingüe y corpus de voz anotados para sistemas de IA empresarial.
Conjuntos de datos de imágenes
Conjuntos de datos visuales anotados para la clasificación, la detección, el OCR y la IA multimodal.
Datos de LLM monolingües
Corpus a gran escala para la adaptación de dominio, el preentrenamiento y los modelos de lenguaje empresariales.
Conjuntos de datos de ajuste de instrucciones
Conjuntos de datos de preguntas y respuestas, y de alineación, para SLM, asistentes y flujos de trabajo de agentes.
Datos de vídeo y multimodales
Anotación temporal, detección de escenas y conjuntos de datos de entrenamiento multimodal.
Qué hace que los datos de entrenamiento estén listos para modelos
No todos los conjuntos de datos son utilizables en sistemas de producción. Los datos listos para modelos suelen requerir desduplicación, normalización, profundidad de metadatos, lógica de anotación, alineación multilingüe cuando sea necesario, filtrado de privacidad y subconjuntos de evaluación dedicados. Estos pasos son muy relevantes porque influyen en el rendimiento, la trazabilidad y el mantenimiento a largo plazo.
Desduplicar y normalizar
Reduzca el ruido, unifique los formatos y mejore la coherencia antes de que comiencen los flujos de trabajo de adaptación o recuperación de modelos.
Añadir metadatos y anotaciones
Capture el idioma, el dominio, la fuente, la intención, el hablante, el contexto, las etiquetas de entidades y otras capas necesarias para el uso operativo.
Evaluar y gobernar
Cree subconjuntos de evaluación, aplique un filtrado con conciencia de privacidad y preserve la trazabilidad para los sistemas de IA empresariales y regulados.
Datos listos para usar frente a estrategias de datos alternativas
Los diferentes programas de IA requieren diferentes rutas de datos. Los conjuntos de datos listos para usar son especialmente útiles cuando la velocidad, el control de calidad y la claridad operativa deben coexistir. Se sitúan en un punto medio productivo entre la recopilación totalmente a medida y los enfoques de datos brutos no controlados.
Comprobado a escala en entornos multilingües y regulados
Las operaciones de datos de Pangeanic se basan en dos décadas de PLN de alto riesgo. Esa experiencia abarca la IA multilingüe, la traducción automática, el procesamiento de datos, la evaluación y los despliegues operativos donde la calidad y el control del lenguaje son muy relevantes. El resultado no es simplemente el acceso a conjuntos de datos, sino el acceso a operaciones de datos que se han perfeccionado bajo una presión institucional y empresarial real.
Más de 10 000 millones de segmentos alineados. Este conjunto de datos multilingües refleja un trabajo a largo plazo en traducción automática, IA interlingüística y canalizaciones de tecnología del lenguaje.
Utilizado en despliegues a escala nacional. Pangeanic ha apoyado la infraestructura lingüística y los flujos de trabajo de lenguaje relacionados con la IA en contextos del sector público y empresarial donde la gobernanza, el control terminológico y la fiabilidad operativa son muy relevantes.
Canalizaciones de evaluación multilingüe. La preparación de conjuntos de datos y la adaptación de modelos requieren más que entradas brutas. Requieren una lógica de evaluación medible, subconjuntos de referencia y flujos de trabajo de calidad que sigan siendo útiles después del despliegue.
Participación en programas europeos. Pangeanic ha contribuido a iniciativas como NTEU, MAPA, ELE, trabajos en espacios de datos con la Universidad Politécnica de Madrid y actividades del ecosistema referenciadas a través de VagrAI y DS4M. Estos esfuerzos forman parte del impulso más amplio de Europa hacia capacidades de IA soberanas y multilingües.
PECAT y operaciones de anotación
- Servicios de anotación en modalidades de texto, voz, imagen y vídeo
- Flujos de trabajo con conciencia de privacidad, que incluyen enmascaramiento, filtrado y revisión estructurada
- Creación de conjuntos de evaluación para pruebas de referencia y validación de modelos
- Soporte para el ajuste de instrucciones y la alineación de sistemas de IA especializados
- Trazabilidad y gobernanza operativa a través de los flujos de trabajo de PECAT
PECAT: La plataforma de procesamiento de datos de Pangeanic estructura los flujos de trabajo de anotación, validación, anonimización y evaluación para que los conjuntos de datos sigan siendo trazables, auditables y continuamente mejorables a lo largo del ciclo de vida de la IA.
¿Cuándo debe utilizar datos de entrenamiento listos para usar?
Los datos de entrenamiento listos para usar son especialmente efectivos cuando los programas de IA necesitan avanzar con rapidez sin sacrificar la estructura, la claridad de las licencias, la lógica de evaluación o la preparación multilingüe.
Cuando el tiempo de despliegue es crítico
Los equipos pueden pasar directamente al ajuste fino, las pruebas de referencia y la preparación de la recuperación sin tener que construir una canalización de conjuntos de datos desde cero.
Cuando se requiere adaptación de dominio
Los corpus especializados ayudan a que los modelos más pequeños y eficientes rindan mejor en flujos de trabajo empresariales donde la terminología y el contexto son muy relevantes.
Cuando se necesita evaluación multilingüe
Los subconjuntos de evaluación estructurados permiten a los equipos comparar el comportamiento del modelo, identificar puntos débiles y mejorar el ajuste en diferentes idiomas y dominios.
Cuando los entornos regulados exigen control
Los conjuntos de datos preparados con lógica de anotación, filtrado, procedencia y gobernanza son más adecuados que la ingestión de corpus no controlada en muchos entornos sensibles.
Preguntas frecuentes técnicas para compradores empresariales y de recuperación de IA
¿Qué son los datos de entrenamiento listos para usar?
Los datos de entrenamiento listos para uso consisten en conjuntos de datos precurados que pueden utilizarse inmediatamente para entrenar, ajustar o evaluar sistemas de IA sin necesidad de realizar una recopilación de datos a gran escala desde cero.
¿Qué tipos de datos proporciona Pangeanic?
Pangeanic proporciona conjuntos de datos de texto multilingüe, datos de preguntas y respuestas y de ajuste de instrucciones, conjuntos de datos de voz y audio, conjuntos de datos de imágenes, y conjuntos de datos de vídeo o multimodales para sistemas de IA empresarial.
¿Cuándo deben las empresas utilizar conjuntos de datos listos para usar?
Estos conjuntos de datos son muy útiles cuando el tiempo de despliegue es crítico, cuando se requiere adaptación de dominio sin construir canalizaciones de datos desde cero, cuando se necesitan conjuntos de datos de evaluación para pruebas de referencia, o cuando los entornos de datos multilingües y regulados requieren una preparación estructurada.
¿Cómo se gestiona la privacidad en los conjuntos de datos listos para usar?
Los conjuntos de datos pueden procesarse a través de flujos de trabajo con conciencia de privacidad que incluyen el enmascaramiento de información de identificación personal (PII), la anonimización, el filtrado de metadatos y la validación humana. Pangeanic aplica estos flujos de trabajo a través de sus operaciones de datos y la plataforma PECAT.
¿Proporciona Pangeanic soporte para la anotación y la evaluación?
Sí. Pangeanic ofrece soporte para la anotación, la evaluación multilingüe, la validación, las pruebas de referencia, el ajuste de instrucciones y la mejora continua de conjuntos de datos como parte de las Operaciones de Datos para IA.
¿Son adecuados los datos listos para usar para los modelos de lenguaje pequeños (SLM)?
Sí. Los datos listos para usar de alta fidelidad son especialmente adecuados para los modelos de lenguaje pequeños, ya que mejoran la adaptación al dominio, reducen el ruido y favorecen una adaptación del modelo más eficiente.