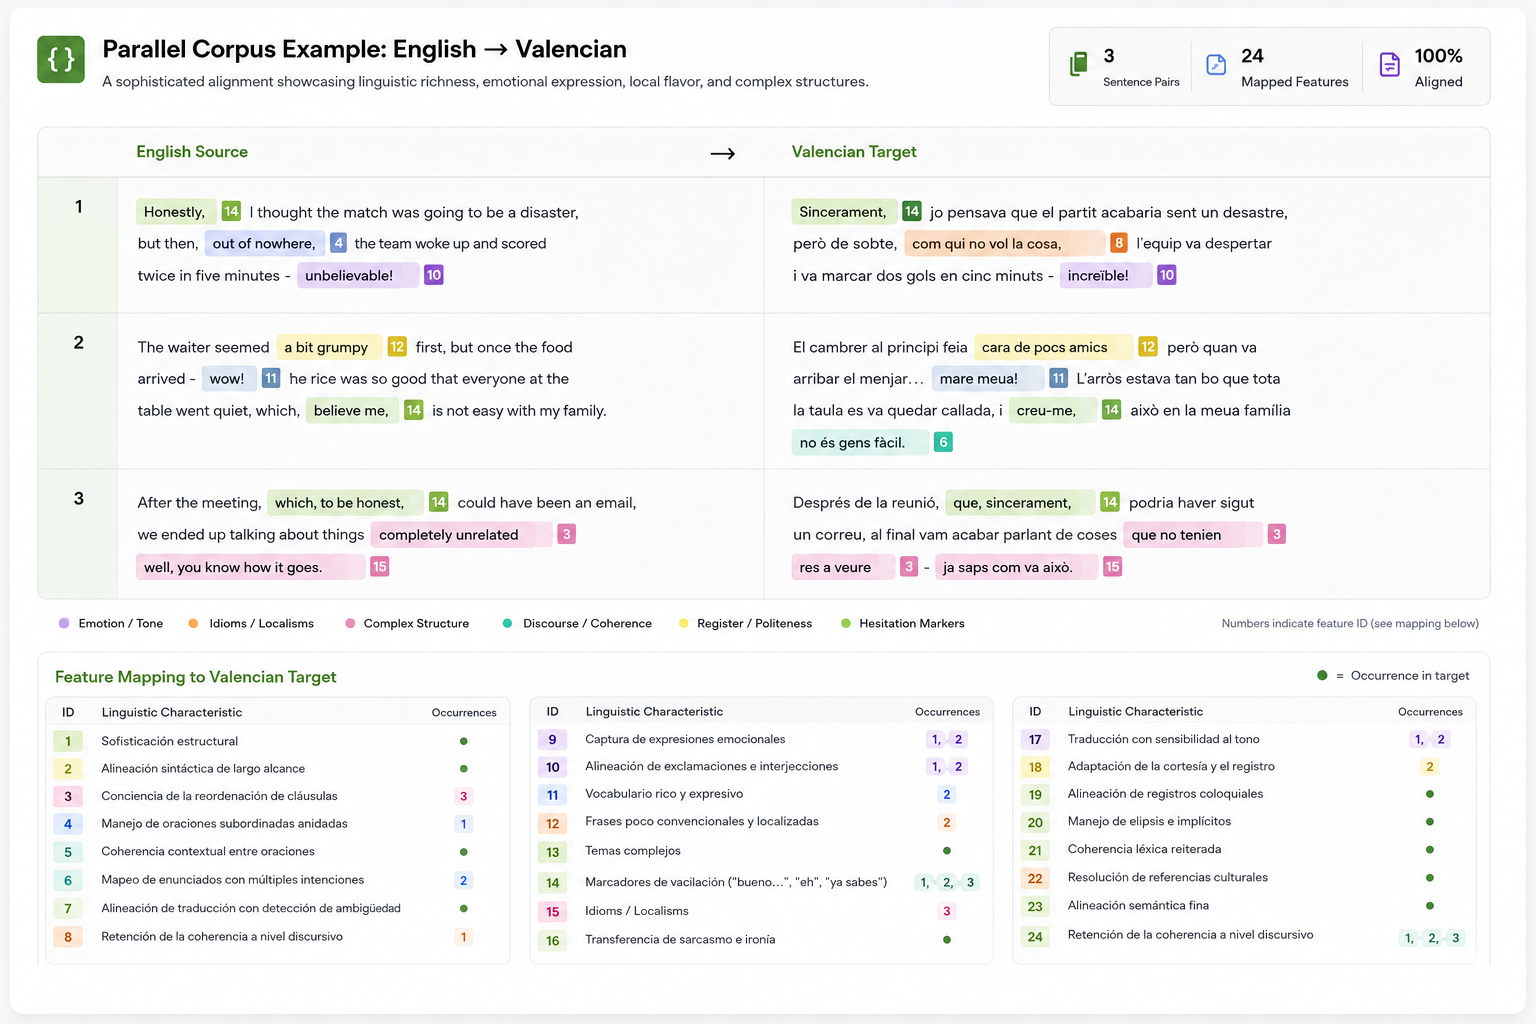
Les corpus parallèles comme infrastructure d’une IA multilingue nativement localisée
Pangeanic traite la création et le traitement des corpus parallèles comme une discipline structurante pour l’IA multilingue. De la collecte de données multilingues à l’alignement précis, en passant par la validation linguistique, le contrôle terminologique et la gouvernance des données, chaque couche vise à réduire le bruit et à préserver la correspondance sémantique entre les langues.
Le résultat n’est pas simplement un texte bilingue, mais une ressource multilingue structurée, prête à alimenter la traduction automatique, la recherche et la récupération d’informations entre les langues, l’adaptation de modèles de langage, les workflows d’évaluation et les systèmes d’IA déployés en production.
Accédez dès aujourd’hui à des corpus parallèles sous licence dans plus de 50 langues
Le catalogue de Pangeanic propose des corpus parallèles sous licence commerciale, conçus pour les agents d’IA multilingues, le fine-tuning des LLM, la traduction automatique, la recherche et la récupération d’informations, les pipelines d’évaluation et les déploiements d’IA en entreprise. Choisissez des corpus prêts à l’emploi ou demandez des combinaisons linguistiques sur mesure adaptées à votre domaine.
Anglais ↔ Espagnol
Corpus alignés à haut volume pour le fine-tuning de LLM, la traduction automatique et les systèmes de récupération multilingues.
Anglais ↔ Allemand
Corpus de niveau entreprise largement utilisés pour la localisation, la gestion terminologique et l’adaptation de la traduction automatique.
Anglais ↔ Français
Vastes corpus bilingues pour les copilotes multilingues, l’évaluation et les workflows de traduction.
Anglais ↔ Italien
Corpus sélectionnés couvrant les domaines entreprise, juridique et les interactions multilingues avec les clients.
Anglais ↔ Arabe
Corpus très demandés pour les systèmes d’IA multilingues desservant les marchés du Moyen-Orient et de l’Afrique du Nord.
Anglais ↔ Chinois
Ensembles bilingues stratégiques pour les LLM multilingues et les applications d’IA d’entreprise.
Vous recherchez une autre paire linguistique ?
Explorez notre catalogue de plus de 50 langues ou demandez des corpus parallèles conçus sur mesure pour votre domaine, vos exigences terminologiques et votre environnement de déploiement.
Que sont les corpus parallèles et pourquoi sont-ils essentiels pour l’IA multilingue ?
Les corpus parallèles sont des collections structurées de textes traduits et alignés au niveau des phrases ou des segments dans deux langues ou plus. Ils sont indispensables à la traduction automatique, à l’IA multilingue, à l’adaptation des modèles de langage et à l’évaluation, car ils montrent comment le sens, la terminologie et la structure correspondent d’une langue à l’autre.
Leur importance s’est renforcée avec l’essor de la traduction automatique statistique, puis neuronale, dans lesquelles la qualité de l’alignement influence directement les performances et le comportement des modèles. Aujourd’hui, ces ensembles de données vont bien au-delà de la traduction : ils soutiennent les modèles de langage multilingues, la génération de texte, la recherche d’informations entre les langues et les workflows d’évaluation de l’IA en entreprise.
Les ressources publiques, comme les comptes rendus parlementaires ou les corpus institutionnels, constituent des bases utiles. Elles restent toutefois souvent limitées à certains domaines et nécessitent un nettoyage, un filtrage et une normalisation approfondis. Dans les environnements de production, la valeur des données parallèles ne dépend pas uniquement de leur disponibilité : elle repose sur la précision de l’alignement, la pertinence du domaine, la cohérence terminologique et la préparation opérationnelle.
Pourquoi les corpus parallèles restent-ils indispensables aux systèmes de traduction avancés ?
Les corpus parallèles restent essentiels, car même les systèmes de traduction avancés ont besoin de données bilingues fiables et traçables. Ils fournissent des textes source et cible alignés, indispensables à l’adaptation des modèles, au contrôle terminologique, à l’évaluation de la qualité, à la couverture de domaines spécialisés, au déploiement dans des environnements privés et à l’amélioration continue avec validation humaine.
Pangeanic conçoit, traite et exploite des corpus parallèles à l’échelle industrielle pour la traduction automatique, l’IA multilingue et les infrastructures linguistiques du secteur public. En 2020, Slator rapportait que Pangeanic avait franchi le cap des 10 milliards de segments de données alignés dans 84 langues. Des projets européens tels que NTEU ont également impliqué la constitution de corpus à grande échelle, la mise en commun et la publication de données pour différentes combinaisons linguistiques de l’UE, contribuant ainsi à la création de moteurs de traduction neuronale et de ressources multilingues réutilisables.
Entraînement et adaptation des modèles
Même les systèmes pré-entraînés les plus performants nécessitent une adaptation pour les contenus juridiques, médicaux, financiers, techniques ou médiatiques. Les corpus parallèles permettent aux modèles d’apprendre la terminologie, le style et les schémas de traduction propres à une organisation, à un domaine ou à un secteur donné.
Évaluation de la qualité des traductions
La qualité d’une traduction ne se mesure pas à la seule fluidité de la sortie. L’évaluation exige des traductions de référence, un jugement humain et des métriques comparant le texte source, la sortie du modèle et la traduction attendue dans la langue cible.
Cohérence terminologique
Les entreprises exigent des traductions qui soient non seulement correctes, mais également cohérentes. Les noms de produits, les termes juridiques, les consignes de sécurité et les formulations de marque doivent être rendus de manière uniforme dans tous les documents, marchés et canaux.
Langues moins dotées et domaines spécialisés
Les systèmes de traduction génériques peinent lorsque la couverture linguistique est limitée ou que le contenu relève d’un domaine professionnel spécialisé. Des corpus parallèles soigneusement sélectionnés, nettoyés et validés apportent les données nécessaires pour améliorer la couverture et obtenir des résultats plus fiables.
Contrôle des données et confidentialité
Les organisations soumises à des exigences réglementaires ne peuvent pas toujours envoyer des textes sensibles vers des API de traduction externes. Des corpus parallèles internes leur permettent d’améliorer leurs systèmes privés tout en conservant le contrôle du contenu, des accès, de la conservation des données et de la gouvernance.
Boucles d’amélioration continue
Les corrections humaines, les retours des réviseurs et les traductions approuvées deviennent de nouveaux exemples alignés. À terme, cette boucle d’amélioration renforce la qualité des traductions, la précision terminologique et la fiabilité des modèles.
Sources : article de Slator consacré au franchissement du cap des 10 milliards de segments de données alignés par Pangeanic ; informations de Pangeanic sur le projet NTEU ; collection de corpus parallèles ouverts OPUS ; tâche partagée WMT General Machine Translation ; et publication de recherche consacrée à COMET et à l’évaluation de la traduction automatique à partir du texte source, de la sortie machine et des traductions de référence. Slator, NTEU, OPUS, WMT, COMET.

Qu’est-ce qui fait d’un corpus parallèle une ressource de données d’entraînement exploitable en production ?
Un corpus parallèle devient une ressource de données d’entraînement exploitable en production lorsque les textes traduits sont alignés, vérifiés, nettoyés, annotés, documentés et préparés pour un modèle ou un workflow spécifique. Sa valeur ne dépend pas uniquement du volume de segments, mais aussi de la qualité de l’alignement, de la pertinence sectorielle, de la couverture linguistique, des métadonnées, de la provenance et de la possibilité de le réutiliser de manière sûre dans des systèmes de production.
Pangeanic structure les corpus parallèles dans le cadre d’opérations de données multilingues plus larges. Cette approche comprend la sélection et l’acquisition des corpus, le nettoyage des mémoires de traduction, l’alignement bilingue, la révision linguistique, le contrôle terminologique, la préparation des métadonnées, la gouvernance des données et l’intégration dans les workflows de traduction automatique, d’IA multilingue et d’évaluation. Elle s’appuie sur une expérience opérationnelle à grande échelle, notamment le franchissement par Pangeanic du cap des 10 milliards d’alignements et sa participation à des projets européens tels que NTEU.
Qualité de l’alignement
La fiabilité d’un corpus parallèle repose sur un alignement précis entre le texte source et le texte cible. La correspondance au niveau des phrases et des segments doit préserver le sens, la terminologie, la structure et le contexte, en particulier lorsque les données servent à entraîner ou à évaluer des systèmes de traduction.
Vérification linguistique
La révision humaine reste essentielle, car les données alignées peuvent contenir des omissions, des contresens, du bruit de formatage, des doublons ou une terminologie incohérente. La vérification linguistique transforme ainsi un matériau bilingue brut en données d’entraînement fiables.
Échelle et disponibilité
Une IA multilingue efficace nécessite du volume, mais les données parallèles exploitables restent rares dans de nombreuses langues et pour de nombreux domaines. Les opérations sur les corpus exigent donc la sélection, le nettoyage, la déduplication et l’extension contrôlée des données selon les paires de langues et les secteurs stratégiques pour le modèle.
Pertinence sectorielle
Un corpus de contrats juridiques, de contenus médicaux, de textes logiciels, de documents administratifs ou de contenus de support client ne peut pas être traité comme un ensemble de textes interchangeables. La pertinence sectorielle détermine si un modèle apprend un comportement de traduction utile ou de simples schémas linguistiques génériques.
Diversité linguistique
Les données de traduction doivent refléter les variations linguistiques selon les régions, les registres, les types de documents et les cas d’usage. Cela permet aux modèles de mieux gérer les environnements multilingues dans lesquels une même langue peut varier selon le marché, le public, la variété linguistique et le contexte professionnel.
Gouvernance opérationnelle
Les corpus utilisés dans des systèmes de production nécessitent des règles claires concernant la provenance, les accès, le filtrage, la conservation, la révision et la réutilisation. Une gouvernance rigoureuse permet aux données multilingues de soutenir l’entraînement, l’évaluation et le déploiement sans exposer de contenus sensibles ni créer de flux de données non contrôlés.
Sources : article de Slator consacré au franchissement du cap des 10 milliards de segments de données alignés par Pangeanic ; informations de Pangeanic sur le projet NTEU ; collection de corpus parallèles ouverts OPUS ; et travaux de recherche associés à OPUS sur les jeux de données multilingues alignés. Slator, NTEU, OPUS, publication de recherche sur OPUS.

Des corpus parallèles livrés à l’échelle industrielle pour l’IA multilingue
La confiance de leaders technologiques mondiaux pour des opérations de données multilingues critiques à grande échelle.
Microsoft
Pangeanic a constitué plus de 50 millions de segments alignés dans plus de 20 langues, avec un accent particulier sur les environnements linguistiques à faibles ressources. Le projet a combiné échelle, précision linguistique et délais d’exécution accélérés pour soutenir l’entraînement de modèles d’IA multilingues destinés à des environnements de production et utilisés par des millions de personnes.
Client confidentiel
Pour une entreprise du Top 10 du NASDAQ, Pangeanic a développé plus de 45 millions de segments dans 27 langues et plusieurs domaines opérationnels. Ces données ont été conçues pour le développement de modèles d’IA multilingues et de traduction, en renforçant la cohérence linguistique d’un système de traduction stratégique utilisé par des millions de personnes.
Amazon
Pangeanic a généré plus de 10 millions de segments alignés dans deux langues, démontrant une forte profondeur linguistique et une grande rigueur opérationnelle pour des paires linguistiques ciblées. Le projet a illustré la capacité de Pangeanic à maintenir qualité et cohérence à grande échelle sur l’ensemble du processus de création des corpus parallèles.
FAQ
Corpus parallèles pour les LLM, la traduction automatique et l’IA multilingue
Cette FAQ explique comment les corpus parallèles sont collectés, évalués, filtrés et utilisés dans les systèmes linguistiques modernes. Les mêmes principes s’appliquent à la traduction automatique, aux modèles de langage multilingues, aux workflows de recherche et de récupération d’informations, aux pipelines d’évaluation et aux systèmes d’IA d’entreprise soumis à une gouvernance.
Quelles métriques sont utilisées pour évaluer la qualité d’un corpus parallèle ?
La qualité d’un corpus parallèle est évaluée selon plusieurs critères : précision de l’alignement, identification de la langue, détection du bruit, suppression des doublons, cohérence du domaine, fidélité terminologique, couverture lexicale et performances obtenues sur les tâches de traduction en aval. Pour la traduction automatique, des métriques de référence comme BLEU et des métriques neuronales comme COMET peuvent être utilisées avec la révision humaine afin de mesurer l’amélioration apportée par le corpus dans des tâches réelles.
Comment les méthodes neuronales utilisent-elles les corpus parallèles pour apprendre des représentations multilingues ?
Les modèles neuronaux exploitent les corpus parallèles pour apprendre comment un même sens s’exprime dans différentes langues. Les phrases parallèles peuvent contribuer aux objectifs de traduction, à l’apprentissage contrastif, aux embeddings multilingues et à la modélisation du langage pour la traduction. Les modèles peuvent ainsi relier des significations équivalentes entre les langues et améliorer leurs performances en recherche multilingue, classification, traduction et génération.
Quels sont les principaux défis de la collecte de données parallèles à grande échelle pour l’entraînement des LLM ?
Les principaux défis sont la rareté des données, le bruit, les erreurs d’alignement, les paires de langues incorrectes, les contenus dupliqués, les blocs de texte standardisés, l’incohérence terminologique et la couverture inégale des domaines. Les données extraites du web peuvent fournir du volume, mais elles nécessitent généralement une détection de la langue, un appariement des phrases, un filtrage, une déduplication, une révision humaine et un équilibrage des domaines avant de devenir des données d’entraînement fiables.
Pourquoi les corpus parallèles sont-ils utiles aux LLM s’ils ne sont pas uniquement des systèmes de traduction ?
Les corpus parallèles aident les LLM à apprendre l’équivalence multilingue, la cohérence terminologique et la préservation du sens entre les langues. Ils sont utiles pour la traduction, l’entraînement par instruction multilingue, la recherche et la récupération d’informations entre les langues, les jeux de données d’évaluation, les données de préférence, l’adaptation de domaine et la génération contrôlée dans des environnements multilingues réglementés.
Comment Pangeanic se distingue-t-elle dans la création de corpus parallèles ?
Pangeanic structure les corpus parallèles comme des pipelines de données multilingues gouvernés, et non comme de simples jeux de données bilingues statiques. Le processus combine sélection et acquisition contrôlées, alignement précis, nettoyage des données, révision linguistique humaine, validation terminologique, préparation des métadonnées, gouvernance et intégration dans les workflows de traduction automatique, de LLM et d’évaluation. Cette approche s’appuie sur l’expérience industrielle de Pangeanic en matière de corpus, notamment le cap des 10 milliards d’alignements et des projets européens tels que NTEU.
Quand une entreprise doit-elle constituer son propre corpus parallèle ?
Une entreprise doit constituer ou qualifier son propre corpus parallèle lorsque les systèmes de traduction génériques ne reflètent pas sa terminologie, son profil de risque, ses besoins en matière de confidentialité, ses types de documents ou ses exigences linguistiques régionales. Les corpus privés sont particulièrement utiles dans les domaines juridique, médical, financier, gouvernemental, technique, du support client et des contenus réglementés.
Sources : article de Slator consacré au franchissement par Pangeanic du cap des 10 milliards de segments de données alignés ; informations du projet NTEU de Pangeanic ; travaux de recherche sur COMET et l’évaluation de la traduction automatique neuronale ; travaux sur XLM et la modélisation du langage pour la traduction ; travaux sur LASER et les représentations de phrases multilingues ; et informations de ParaCrawl sur l’extraction à grande échelle de corpus parallèles. Slator, NTEU, COMET, recherche XLM, recherche LASER, ParaCrawl.
PECAT pour la création et la gestion de corpus parallèles
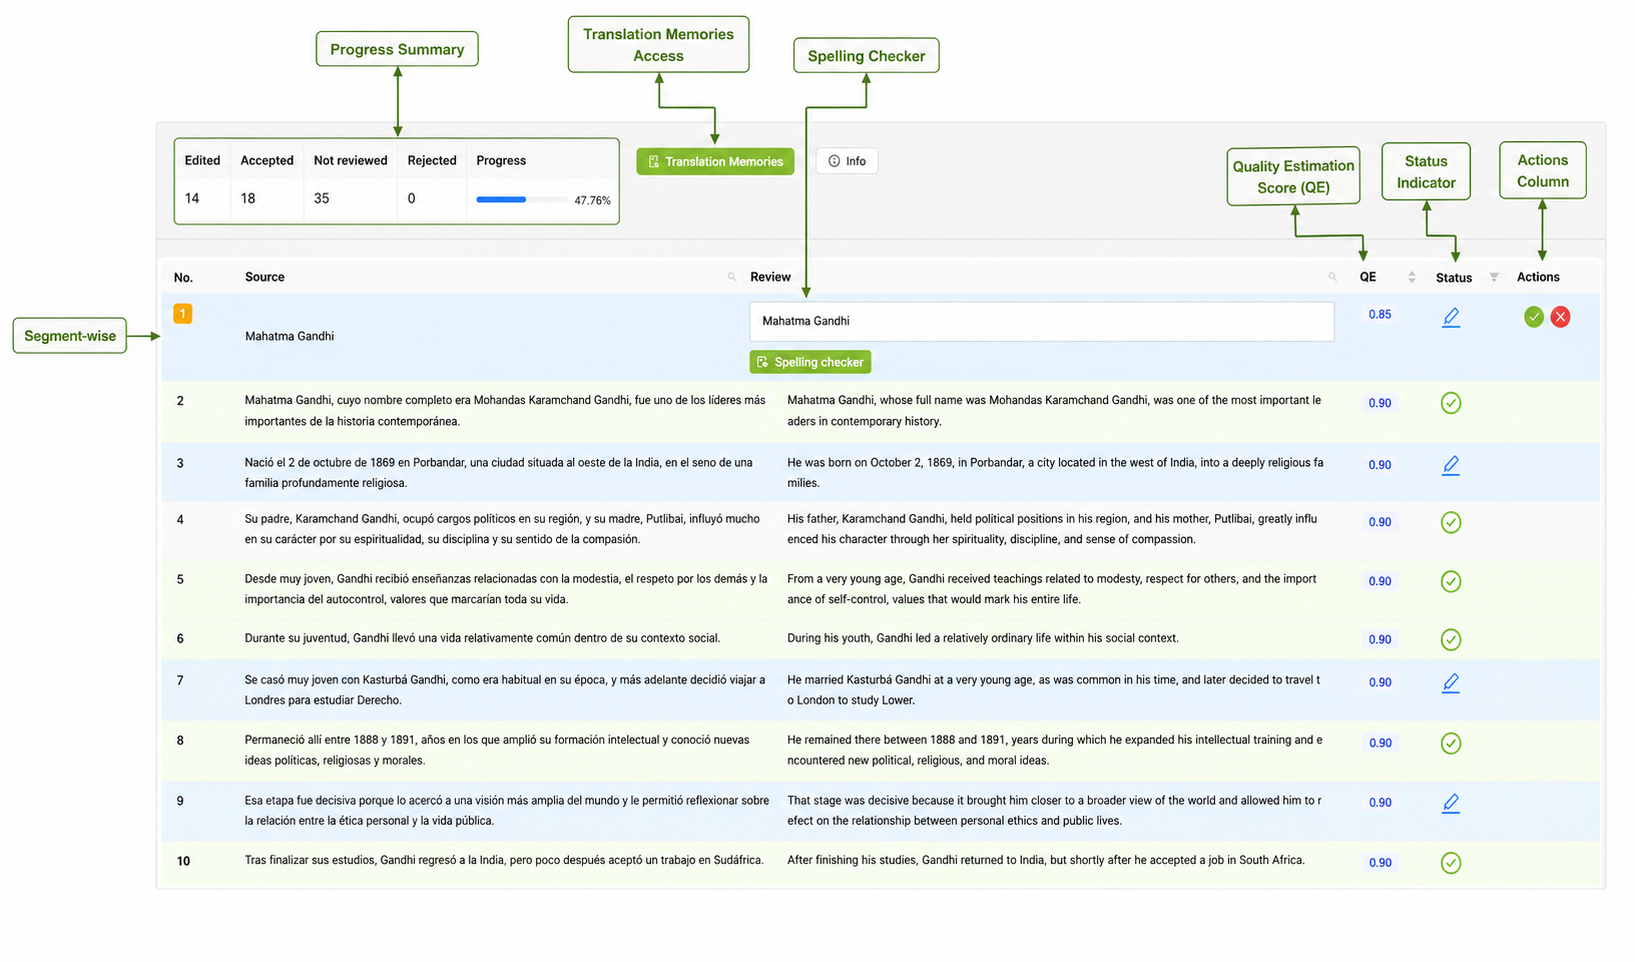
PECAT est la plateforme de Pangeanic dédiée à l’orchestration des opérations de données multilingues et multimodales. Pour les corpus parallèles, elle permet de piloter la sélection et l’acquisition des données bilingues, l’alignement des segments, l’annotation, le contrôle qualité, la validation terminologique et la gouvernance au sein d’un même processus opérationnel.
Cette approche est essentielle, car la création d’un corpus parallèle ne se limite pas à une tâche de traduction. Il s’agit d’un flux d’ingénierie des données et de validation linguistique dans lequel chaque segment doit rester traçable, révisable et exploitable pour la traduction automatique, le fine-tuning des LLM, l’évaluation et le déploiement de systèmes d’IA multilingues.
Acquisition et préparation de données parallèles
Pangeanic utilise PECAT pour coordonner la sélection, l’acquisition, la préparation et le contrôle des données bilingues et multilingues. La plateforme structure l’ingestion selon les langues, les domaines, les formats et les exigences spécifiques de chaque projet.
- Collecte de contenus multilingues issus de sources sélectionnées, propriétaires et institutionnelles
- Acquisition de données pour les domaines juridique, médical, technique, public et d’entreprise
- Préparation de données bilingues pour les mémoires de traduction, les corpus d’entraînement et les workflows de modèles
- Ingestion contrôlée, tableaux de bord de projet, gestion des fournisseurs et suivi de production
- Traitement sécurisé des contenus sensibles, avec des flux d’anonymisation si nécessaire
Alignement, annotation et révision
PECAT gère la phase de préparation et de contrôle durant laquelle les segments sources et cibles sont alignés, vérifiés, annotés et préparés pour les systèmes de traduction automatique et d’IA multilingue. Les contrôles automatisés et la révision humaine experte sont combinés pour préserver le sens, la terminologie et l’intégrité du jeu de données.
- Alignement des phrases et des segments pour différentes paires de langues
- Enrichissement terminologique, métadonnées et balisage pour le contrôle et la réutilisation du corpus
- Prise en charge des glossaires et des expressions régulières (regex) pour améliorer la précision de l’annotation
- Révision humaine associée à des contrôles qualité automatisés et à des contrôles AutoQA
- Rapports qualité assurant la traçabilité, l’auditabilité et l’amélioration continue
Sources : informations de Pangeanic sur la plateforme PECAT et les services d’annotation de texte. Plateforme PECAT, services d’annotation de texte.
Des opérations de données soutenues par des normes de qualité reconnues
Les opérations de données et de technologies linguistiques de Pangeanic s’appuient sur des systèmes de management certifiés pour la qualité, les services de traduction, la sécurité de l’information, le management de la qualité des dispositifs médicaux et la post-édition humaine des sorties de traduction automatique. Ces référentiels encadrent les flux PECAT afin de les rendre cohérents, sécurisés, auditables et fiables dans les environnements de production.
Sources : informations officielles de l’ISO sur le management de la qualité, les services de traduction, la sécurité de l’information, le management de la qualité des dispositifs médicaux et la post-édition humaine des sorties de traduction automatique. ISO 9001, ISO 17100, ISO/IEC 27001, ISO 13485, ISO 18587.
DATA LAKE DE CORPUS PARALLÈLES
Corpus parallèles à grande échelle pour l’IA multilingue et la traduction automatique
Pangeanic fournit des corpus parallèles à grande échelle et des jeux de données d’entraînement pour l’IA multilingue à partir d’un référentiel de plus de 10 milliards de segments alignés, complété par des opérations de données sur mesure adaptées aux exigences de chaque modèle, domaine et paire de langues. Chaque projet s’appuie sur la qualité des données, la précision linguistique, le contrôle terminologique et une livraison gouvernée, prête pour la production.
Explorer les jeux de données associés
Collecte de données multilingues, révision humaine, métadonnées structurées et pipelines de livraison gouvernés pour les environnements de production des entreprises et du secteur public.