Corpus paralelos como infraestructura de una IA multilingüe localizada de forma nativa
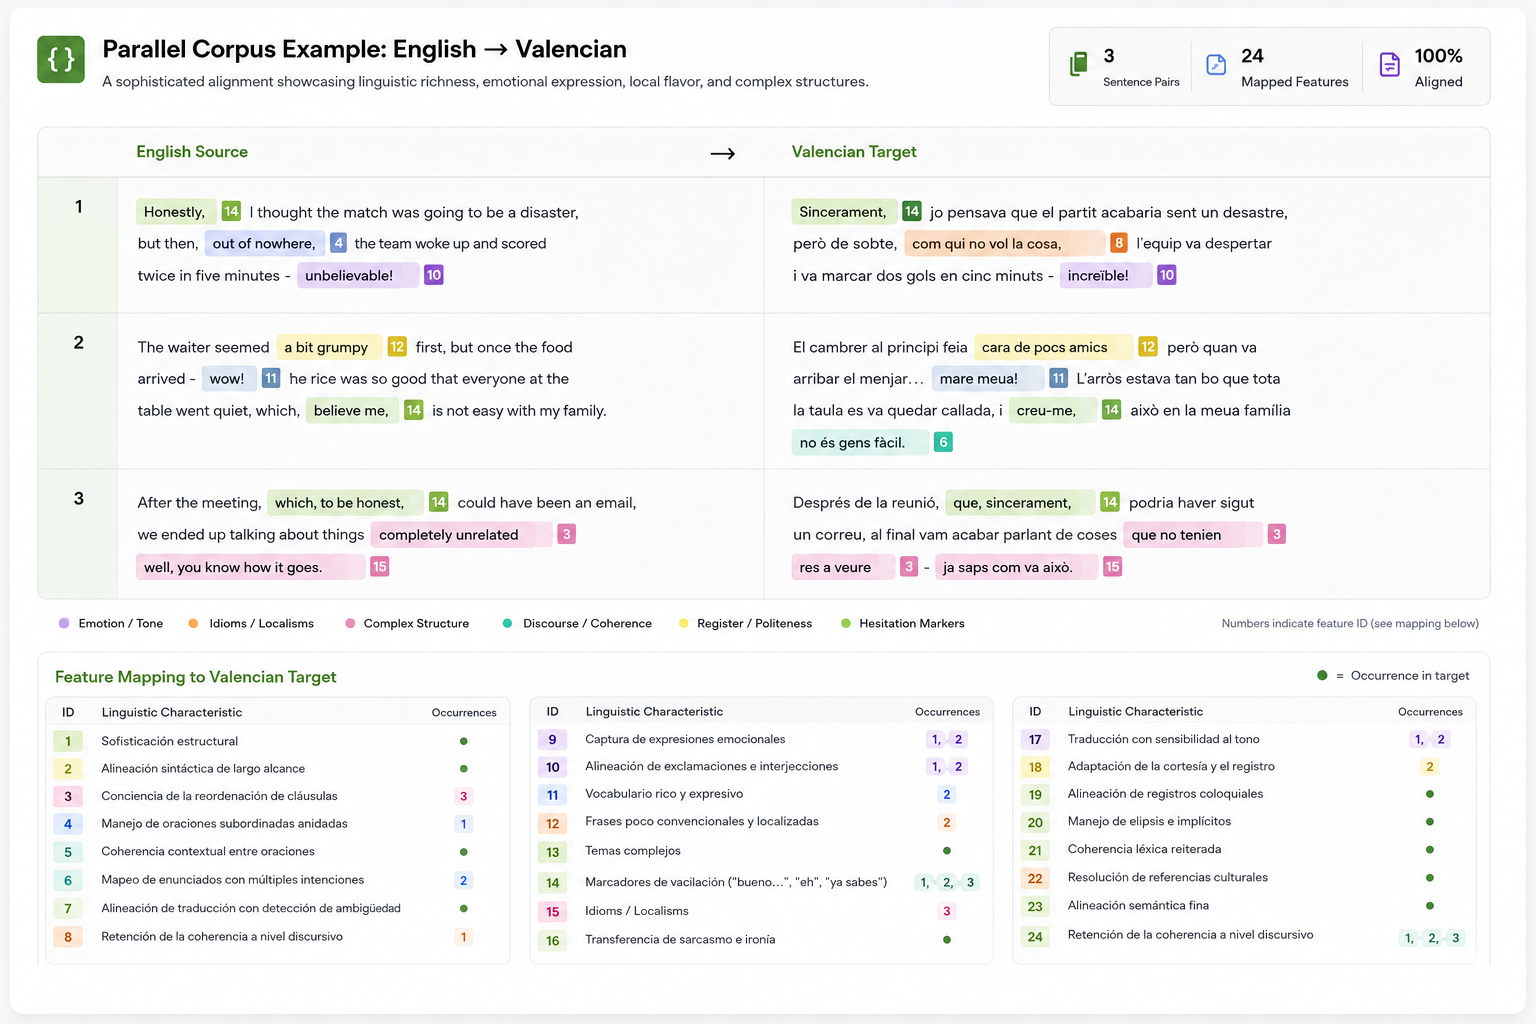
En Pangeanic tratamos la creación y el procesamiento de corpus paralelos como una disciplina estructural de la IA multilingüe. Desde la recopilación de datos multilingües hasta la alineación precisa, pasando por la validación lingüística, el control terminológico y la gobernanza de datos, cada capa busca reducir el ruido y preservar la correspondencia semántica entre lenguas.
El resultado no es un simple texto bilingüe, sino un recurso multilingüe estructurado, listo para alimentar la traducción automática, la búsqueda y recuperación de información entre lenguas, la adaptación de modelos de lenguaje, los flujos de evaluación y los sistemas de IA desplegados en producción.
Corpus paralelos para grandes idiomas y combinaciones difíciles de obtener
Pangeanic ofrece corpus paralelos con licencia comercial para entrenamiento y adaptación de modelos multilingües, traducción automática, recuperación de información, evaluación y aplicaciones empresariales de IA. El catálogo combina grandes pares internacionales con recursos especialmente relevantes para España, Europa y mercados multilingües donde los datos paralelos de calidad son más difíciles de encontrar.
Puede adquirir corpus existentes o solicitar una selección adaptada a su caso de uso, idioma, dominio, volumen, formato, requisitos de licencia y criterios de calidad.
Corpus especialmente relevantes para español y lenguas ibéricas
Además de los grandes pares internacionales, Pangeanic dispone de activos paralelos de gran volumen para español, catalán, valenciano y euskera, junto con recursos adicionales para gallego y aranés. Estos datos pueden utilizarse en proyectos de IA multilingüe, adaptación lingüística, traducción automática, evaluación y desarrollo de modelos con mayor cobertura de lenguas y variedades locales.
Castellano ↔ Valenciano
Datos paralelos de gran volumen para modelos multilingües, adaptación de dominio, traducción automática y sistemas dirigidos a contextos valencianos.
Castellano ↔ Catalán
Corpus paralelos para entrenamiento, adaptación y evaluación de sistemas bilingües y multilingües que operan con castellano y catalán.
Español ↔ Euskera
Un activo multilingüe especialmente relevante para modelos, traducción, evaluación y aplicaciones que necesitan trabajar de forma fiable con euskera.
Inglés ↔ Español
Corpus de gran volumen para entrenamiento y fine tuning de modelos, traducción automática, recuperación multilingüe y evaluación.
Gallego y aranés
Pangeanic dispone también de recursos paralelos en gallego y aranés en volúmenes menores, útiles para ampliar cobertura lingüística, construir conjuntos de evaluación o mejorar sistemas existentes.
Consulte disponibilidad, pares lingüísticos, volumen y condiciones de licencia.
Corpus paralelos de gran volumen para IA multilingüe
El catálogo incluye también grandes colecciones bilingües para idiomas internacionales de alta demanda. Pueden utilizarse de forma independiente o combinarse dentro de programas multilingües más amplios.
Inglés ↔ Alemán
Datos paralelos para modelos lingüísticos, localización empresarial, adaptación terminológica y traducción automática.
Inglés ↔ Francés
Corpus bilingües de gran volumen para entrenamiento, evaluación, recuperación multilingüe y producción lingüística.
Inglés ↔ Italiano
Recursos paralelos para aplicaciones empresariales, traducción automática, adaptación de modelos y evaluación.
Inglés ↔ Árabe
Datos para sistemas de IA multilingüe que necesitan conectar contenido en inglés y árabe para entrenamiento, adaptación y producción.
Francés ↔ Árabe
Corpus especialmente interesante para aplicaciones multilingües en Europa, norte de África y otros entornos donde francés y árabe conviven operativamente.
Inglés ↔ Chino
Colecciones bilingües de gran volumen para LLM multilingües, sistemas de traducción, recuperación y aplicaciones empresariales de IA.
Mucho más que los pares principales
Pangeanic dispone además de millones de segmentos paralelos en otras combinaciones lingüísticas. La disponibilidad concreta depende del par, el volumen requerido, el dominio y las condiciones de licencia.
Estas lenguas están disponibles en distintas combinaciones con español, catalán, francés, alemán o inglés. Podemos confirmar el inventario, el volumen y los derechos disponibles para el par concreto que necesite.
Díganos qué necesita hacer con los datos
El volumen por sí solo no determina si un corpus es adecuado para su proyecto. El uso previsto, los derechos, la procedencia, el dominio, la calidad del alineamiento, la cobertura lingüística y el formato de entrega son igualmente importantes.
Indíquenos los idiomas, dirección, variedad regional y cualquier requisito de equilibrio entre lenguas.
Especifique el número aproximado de segmentos, palabras o documentos que necesita.
Entrenamiento, fine tuning, traducción automática, RAG, evaluación, terminología, investigación o producción.
Defina los derechos requeridos, formato técnico, metadatos, dominio y cualquier restricción de redistribución.
Consulte nuestro inventario o solicite una combinación lingüística específica
Podemos confirmar disponibilidad, volumen, características técnicas y condiciones de licencia para corpus existentes, o preparar un programa de recopilación, alineamiento y validación cuando el recurso que necesita todavía no existe.
Catálogo actualizado el .
¿Qué son los corpus paralelos y por qué son esenciales para la IA multilingüe?
Los corpus paralelos son colecciones estructuradas de textos traducidos y alineados a nivel de oración o de segmento en dos o más lenguas. Son imprescindibles para la traducción automática, la IA multilingüe, la adaptación de modelos de lenguaje y la evaluación, porque muestran cómo se corresponden el significado, la terminología y la estructura de una lengua a otra.
Su importancia creció con el auge de la traducción automática estadística y, después, de la neuronal, en las que la calidad de la alineación influye directamente en el rendimiento y el comportamiento de los modelos. Hoy, estos conjuntos de datos van mucho más allá de la traducción: sustentan los modelos de lenguaje multilingües, la generación de texto, la búsqueda y recuperación de información entre lenguas y los flujos de evaluación de la IA empresarial.
Los recursos públicos, como las actas parlamentarias o los corpus institucionales, son una buena base de partida. Sin embargo, suelen limitarse a determinados dominios y requieren una limpieza, un filtrado y una normalización a fondo. En entornos de producción, el valor de los datos paralelos no depende solo de su disponibilidad, sino de la precisión de la alineación, la pertinencia para el dominio, la coherencia terminológica y su preparación para el uso operativo.
¿Por qué siguen siendo imprescindibles los corpus paralelos para los sistemas de traducción avanzados?
Los corpus paralelos siguen siendo esenciales porque incluso los sistemas de traducción más avanzados necesitan datos bilingües fiables y trazables. Aportan textos de origen y de destino alineados, imprescindibles para adaptar los modelos, controlar la terminología, evaluar la calidad, cubrir dominios especializados, desplegar en entornos privados y mejorar de forma continua con validación humana.
En Pangeanic diseñamos, procesamos y explotamos corpus paralelos a escala industrial para la traducción automática, la IA multilingüe y las infraestructuras lingüísticas del sector público. En 2020, Slator informó de que Pangeanic había superado los 10 000 millones de segmentos de datos alineados en 84 idiomas. Proyectos europeos como NTEU también supusieron la creación de corpus a gran escala, la puesta en común y la publicación de datos para distintas combinaciones lingüísticas de la UE, lo que contribuyó a crear motores de traducción neuronal y recursos multilingües reutilizables.
Entrenamiento y adaptación de modelos
Incluso los sistemas preentrenados más potentes necesitan adaptarse a contenidos jurídicos, médicos, financieros, técnicos o periodísticos. Los corpus paralelos permiten a los modelos aprender la terminología, el estilo y los patrones de traducción propios de una organización, un dominio o un sector concreto.
Evaluación de la calidad de la traducción
La calidad de una traducción no se mide solo por la fluidez del resultado. Evaluarla exige traducciones de referencia, juicio humano y métricas que comparen el texto de origen, la salida del modelo y la traducción esperada en la lengua de destino.
Coherencia terminológica
Las empresas exigen traducciones que no solo sean correctas, sino también coherentes. Los nombres de producto, los términos jurídicos, las instrucciones de seguridad y las formulaciones de marca deben traducirse de manera uniforme en todos los documentos, mercados y canales.
Lenguas con pocos recursos y dominios especializados
Los sistemas de traducción genéricos fallan cuando la cobertura lingüística es limitada o cuando el contenido pertenece a un ámbito profesional especializado. Unos corpus paralelos bien seleccionados, depurados y validados aportan los datos necesarios para ampliar la cobertura y obtener resultados más fiables.
Control de los datos y confidencialidad
Las organizaciones sujetas a requisitos normativos no siempre pueden enviar textos sensibles a API de traducción externas. Los corpus paralelos internos les permiten mejorar sus sistemas privados sin perder el control sobre el contenido, los accesos, la conservación de los datos y la gobernanza.
Ciclos de mejora continua
Las correcciones humanas, los comentarios de los revisores y las traducciones aprobadas se convierten en nuevos ejemplos alineados. Con el tiempo, este ciclo de mejora refuerza la calidad de la traducción, la precisión terminológica y la fiabilidad de los modelos.
Fuentes: artículo de Slator sobre la superación por parte de Pangeanic de los 10 000 millones de segmentos de datos alineados; información de Pangeanic sobre el proyecto NTEU; colección de corpus paralelos abiertos OPUS; tarea compartida WMT General Machine Translation; y publicación de investigación sobre COMET y la evaluación de la traducción automática a partir del texto de origen, la salida automática y las traducciones de referencia. Slator, NTEU, OPUS, WMT, COMET.

¿Qué convierte un corpus paralelo en datos de entrenamiento listos para producción?
Un corpus paralelo se convierte en datos de entrenamiento listos para producción cuando los textos traducidos están alineados, verificados, depurados, anotados, documentados y preparados para un modelo o un flujo de trabajo concreto. Su valor no depende solo del volumen de segmentos, sino también de la calidad de la alineación, la pertinencia para el sector, la cobertura lingüística, los metadatos, la procedencia y la posibilidad de reutilizarlo con seguridad en sistemas de producción.
En Pangeanic estructuramos los corpus paralelos dentro de unas operaciones de datos multilingües más amplias. Este enfoque abarca la selección y obtención de corpus, la limpieza de memorias de traducción, la alineación bilingüe, la revisión lingüística, el control terminológico, la preparación de metadatos, la gobernanza de datos y la integración en flujos de traducción automática, IA multilingüe y evaluación. Se apoya en una experiencia operativa a gran escala, que incluye haber superado los 10 000 millones de alineaciones y la participación en proyectos europeos como NTEU.
Calidad de la alineación
La fiabilidad de un corpus paralelo depende de una alineación precisa entre el texto de origen y el de destino. La correspondencia a nivel de oración y de segmento debe preservar el significado, la terminología, la estructura y el contexto, sobre todo cuando los datos se usan para entrenar o evaluar sistemas de traducción.
Verificación lingüística
La revisión humana sigue siendo esencial, porque los datos alineados pueden contener omisiones, errores de sentido, ruido de formato, duplicados o terminología incoherente. La verificación lingüística convierte así el material bilingüe en bruto en datos de entrenamiento fiables.
Escala y disponibilidad
Una IA multilingüe eficaz necesita volumen, pero los datos paralelos utilizables siguen siendo escasos en muchas lenguas y dominios. Por eso, las operaciones con corpus exigen seleccionar, depurar, deduplicar y ampliar los datos de forma controlada según los pares de idiomas y los sectores estratégicos para el modelo.
Pertinencia sectorial
Un corpus de contratos, contenido médico, textos de software, documentos administrativos o contenido de atención al cliente no puede tratarse como un conjunto de textos intercambiables. La pertinencia sectorial determina si un modelo aprende un comportamiento de traducción útil o simples patrones lingüísticos genéricos.
Diversidad lingüística
Los datos de traducción deben reflejar la variación lingüística entre regiones, registros, tipos de documento y casos de uso. Así, los modelos gestionan mejor los entornos multilingües, en los que una misma lengua puede variar según el mercado, el público, la variedad lingüística y el contexto profesional.
Gobernanza operativa
Los corpus que se usan en sistemas de producción necesitan reglas claras sobre procedencia, accesos, filtrado, conservación, revisión y reutilización. Una gobernanza rigurosa permite que los datos multilingües sirvan para el entrenamiento, la evaluación y el despliegue sin exponer contenido sensible ni generar flujos de datos sin control.
Fuentes: artículo de Slator sobre la superación por parte de Pangeanic de los 10 000 millones de segmentos de datos alineados; información de Pangeanic sobre el proyecto NTEU; colección de corpus paralelos abiertos OPUS; y trabajos de investigación asociados a OPUS sobre conjuntos de datos multilingües alineados. Slator, NTEU, OPUS, publicación de investigación sobre OPUS.

Corpus paralelos entregados a escala industrial para la IA multilingüe
Líderes tecnológicos mundiales confían en nosotros para operaciones de datos multilingües críticas y a gran escala.
Microsoft
Pangeanic creó más de 50 millones de segmentos alineados en más de 20 idiomas, con especial atención a las lenguas con pocos recursos. El proyecto combinó escala, precisión lingüística y plazos de entrega reducidos para el entrenamiento de modelos de IA multilingüe destinados a entornos de producción y utilizados por millones de personas.
Cliente confidencial
Para una empresa del Top 10 del NASDAQ, Pangeanic desarrolló más de 45 millones de segmentos en 27 idiomas y varios dominios operativos. Los datos se diseñaron para desarrollar modelos de IA multilingüe y de traducción, y reforzaron la coherencia lingüística de un sistema de traducción estratégico utilizado por millones de personas.
Amazon
Pangeanic generó más de 10 millones de segmentos alineados en dos idiomas, con gran profundidad lingüística y rigor operativo en pares de idiomas específicos. El proyecto demostró la capacidad de Pangeanic para mantener la calidad y la coherencia a gran escala en todo el proceso de creación de corpus paralelos.
Corpus paralelos para LLM, traducción automática e IA multilingüe
Estas preguntas responden a los aspectos que más importan al seleccionar, licenciar, construir y evaluar datos paralelos: calidad, alineación, procedencia, derechos de uso, cobertura lingüística y utilidad real para modelos y sistemas de IA.
¿Qué determina realmente la calidad de un corpus paralelo?
La calidad no depende únicamente del número de segmentos. Un corpus paralelo debe evaluarse por la precisión del alineamiento, la identificación correcta del idioma y de la variedad lingüística, la equivalencia semántica, la eliminación de duplicados y ruido, la coherencia terminológica, la cobertura de dominios, los metadatos, la procedencia de los datos y los derechos asociados a su uso. En proyectos exigentes también conviene utilizar muestreo y revisión humana para comprobar que los segmentos aceptados cumplen los criterios definidos para el modelo o sistema de destino.
¿Cómo se comprueba si un corpus paralelo mejora realmente un modelo?
La calidad interna del corpus y el rendimiento del modelo son dos niveles distintos. Primero se valida el dato: alineación, idioma, duplicación, terminología, dominio y procedencia. Después se mide su impacto aguas abajo con un conjunto de evaluación independiente. En traducción automática pueden utilizarse métricas como BLEU o métricas neuronales como COMET, acompañadas cuando sea necesario de evaluación humana. Para otros sistemas pueden medirse precisión, recuperación, cobertura terminológica, consistencia entre lenguas o éxito en una tarea concreta.
¿Cómo utilizan los modelos neuronales y los LLM los corpus paralelos?
Los corpus paralelos muestran cómo se expresa un mismo significado en diferentes lenguas. Pueden proporcionar señal supervisada para traducción, aprendizaje entre lenguas y adaptación multilingüe, y también ayudar a construir representaciones compartidas entre idiomas. Esto resulta útil para traducción, búsqueda y recuperación multilingüe, clasificación, adaptación de modelos, creación de datos de instrucciones y evaluación de la equivalencia semántica entre lenguas.
¿Cuáles son los principales retos al recopilar datos paralelos a gran escala?
Entre los principales retos se encuentran los errores de alineación, la identificación incorrecta del idioma, el contenido duplicado, el texto repetitivo o boilerplate, el ruido, las traducciones parciales, la incoherencia terminológica, la cobertura desigual de dominios y el desequilibrio entre lenguas. A ello se añaden cuestiones que hoy son esenciales para IA empresarial, como procedencia, derechos de uso, trazabilidad y posible contaminación entre datos de entrenamiento y evaluación. La extracción a gran escala aporta volumen, pero requiere filtrado, deduplicación, clasificación, control de calidad y validación antes de convertirse en un recurso fiable.
¿Qué debería comprobar una empresa antes de licenciar un corpus paralelo?
Además del volumen y el par lingüístico, conviene confirmar para qué usos está autorizado el corpus: entrenamiento, fine tuning, evaluación, uso interno, productos comerciales, creación de derivados o redistribución, según corresponda. También deben especificarse la procedencia, el dominio, el periodo cubierto, el formato, los metadatos, el método de alineación, los controles de calidad y cualquier restricción. Un corpus de gran tamaño puede tener poco valor operativo si sus derechos o características no permiten utilizarlo para el caso de uso previsto.
¿Dispone Pangeanic de corpus para lenguas y combinaciones menos representadas?
Sí. Además de grandes pares internacionales, el inventario incluye recursos relevantes para el ecosistema lingüístico español y europeo, como castellano ↔ valenciano, castellano ↔ catalán y español ↔ euskera, además de recursos en gallego y aranés. También existen millones de segmentos en diferentes combinaciones con chino, japonés, coreano, vietnamita, portugués brasileño, ruso, ucraniano, árabe, español, catalán, francés, alemán e inglés. La disponibilidad exacta debe confirmarse según el par, el volumen y los derechos necesarios.
¿Qué diferencia a Pangeanic en la creación y preparación de corpus paralelos?
Pangeanic trata los corpus paralelos como una operación de datos multilingües, no como simples archivos bilingües. El proceso puede combinar obtención y selección de datos, alineación, filtrado, deduplicación, revisión lingüística humana, control terminológico, metadatos, validación y gobernanza. Esta capacidad se apoya en una trayectoria industrial de gran escala: Pangeanic anunció en 2020 haber superado los 10.000 millones de segmentos alineados, y posteriormente participó en iniciativas europeas como NTEU, que combinaron recopilación de datos, preparación de corpus, entrenamiento y evaluación multilingüe para las lenguas oficiales de la Unión Europea.
¿Cuándo conviene crear un corpus paralelo a medida en lugar de comprar uno existente?
Un corpus existente suele ser la opción más rápida cuando el par lingüístico, el dominio, los derechos y la calidad requerida ya están cubiertos. Conviene construir o ampliar un corpus específico cuando su organización necesita terminología propia, contenido especializado, variedades regionales concretas, mayor confidencialidad, formatos particulares, cobertura que no existe en el mercado o datos de evaluación independientes. En esos casos, el corpus puede diseñarse desde el principio según la tarea, el modelo, los criterios de aceptación y el entorno de despliegue.
Fuentes y referencias técnicas: hito histórico de Pangeanic de más de 10.000 millones de segmentos alineados, publicado como nota de Pangeanic en Slator; documentación de Pangeanic sobre NTEU; investigación sobre COMET para evaluación de traducción automática; trabajos sobre XLM y aprendizaje multilingüe supervisado con datos paralelos; investigación sobre LASER y representaciones multilingües de oraciones; y documentación de ParaCrawl sobre extracción y preparación de corpus paralelos a gran escala. Slator , NTEU , COMET , XLM , LASER , ParaCrawl .
PECAT para la creación y gestión de corpus paralelos
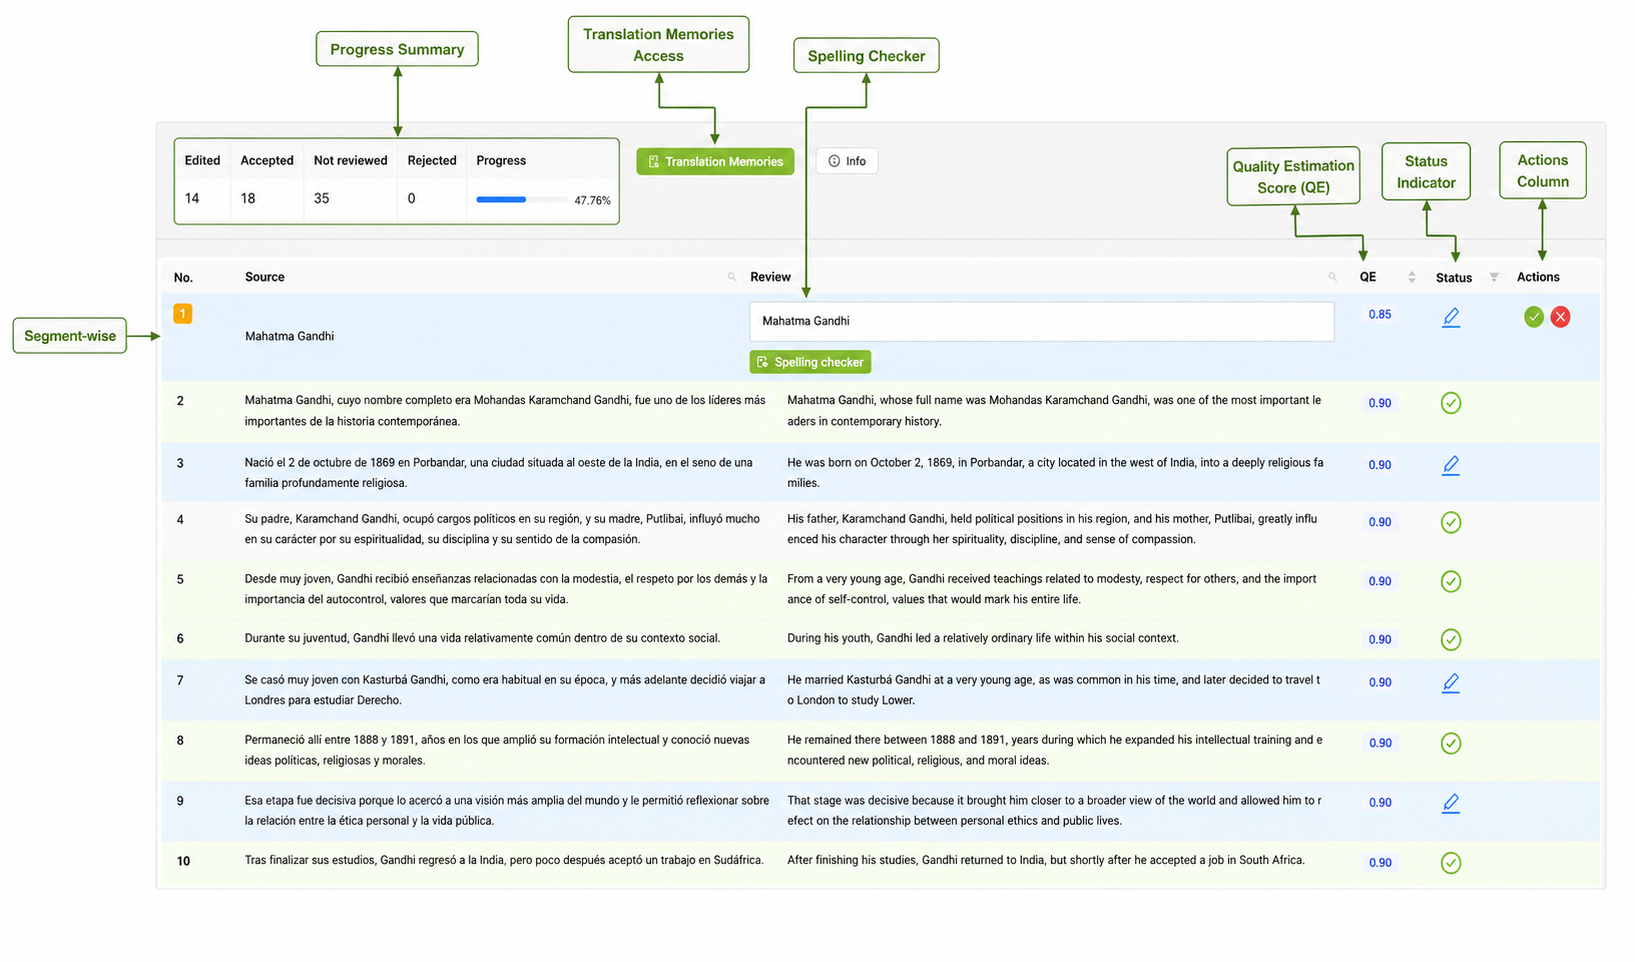
PECAT es la plataforma de Pangeanic para orquestar operaciones de datos multilingües y multimodales. En el caso de los corpus paralelos, permite gestionar la selección y obtención de datos bilingües, la alineación de segmentos, la anotación, el control de calidad, la validación terminológica y la gobernanza dentro de un mismo proceso operativo.
Este enfoque es esencial porque crear un corpus paralelo no se reduce a una tarea de traducción. Es un flujo de ingeniería de datos y validación lingüística en el que cada segmento debe seguir siendo trazable, revisable y utilizable para la traducción automática, el fine-tuning de LLM, la evaluación y el despliegue de sistemas de IA multilingüe.
Obtención y preparación de datos paralelos
En Pangeanic usamos PECAT para coordinar la selección, obtención, preparación y control de datos bilingües y multilingües. La plataforma estructura la ingesta según los idiomas, los dominios, los formatos y los requisitos específicos de cada proyecto.
- Recopilación de contenido multilingüe procedente de fuentes seleccionadas, propietarias e institucionales
- Obtención de datos para los ámbitos jurídico, médico, técnico, público y empresarial
- Preparación de datos bilingües para memorias de traducción, corpus de entrenamiento y flujos de modelos
- Ingesta controlada, paneles de proyecto, gestión de proveedores y seguimiento de la producción
- Tratamiento seguro de contenido sensible, con flujos de anonimización cuando es necesario
Alineación, anotación y revisión
PECAT gestiona la fase de preparación y control en la que los segmentos de origen y de destino se alinean, verifican, anotan y preparan para los sistemas de traducción automática y de IA multilingüe. Los controles automáticos se combinan con la revisión humana experta para preservar el significado, la terminología y la integridad del conjunto de datos.
- Alineación de oraciones y segmentos para distintos pares de idiomas
- Enriquecimiento terminológico, metadatos y etiquetado para controlar y reutilizar el corpus
- Uso de glosarios y expresiones regulares (regex) para mejorar la precisión de la anotación
- Revisión humana combinada con controles de calidad automáticos y AutoQA
- Informes de calidad que garantizan la trazabilidad, la auditabilidad y la mejora continua
Fuentes: información de Pangeanic sobre la plataforma PECAT y los servicios de anotación de texto. Plataforma PECAT, servicios de anotación de texto.
Operaciones de datos respaldadas por normas de calidad reconocidas
Nuestras operaciones de datos y tecnología lingüística se apoyan en sistemas de gestión certificados de calidad, servicios de traducción, seguridad de la información, gestión de la calidad de productos sanitarios y posedición humana de la traducción automática. Estas normas enmarcan los flujos de PECAT para que sean coherentes, seguros, auditables y fiables en entornos de producción.
Fuentes: información oficial de ISO sobre gestión de la calidad, servicios de traducción, seguridad de la información, gestión de la calidad de productos sanitarios y posedición humana de la traducción automática. ISO 9001, ISO 17100, ISO/IEC 27001, ISO 13485, ISO 18587.
Data lake de corpus paralelos
Corpus paralelos a gran escala para la IA multilingüe y la traducción automática
En Pangeanic ofrecemos corpus paralelos a gran escala y conjuntos de datos de entrenamiento para la IA multilingüe a partir de un repositorio de más de 10 000 millones de segmentos alineados, complementado con operaciones de datos a medida según los requisitos de cada modelo, dominio y par de idiomas. Cada proyecto se apoya en la calidad de los datos, la precisión lingüística, el control terminológico y una entrega gobernada y lista para producción.